GitHub Actionsですべてのプルリクエストに自動テストを設定する方法
 Rui Li
プロダクトレイヤーのテストをすべてのプルリクエストで実行させることは複雑ではありませんが、中途半端なセットアップでは一部の失敗しか検出できない状態になりがちです。実際に必要なセットアップの内容と、稼働後に確認すべき事項をご説明します。
「すべてのプルリクエスト」が実際に要求すること
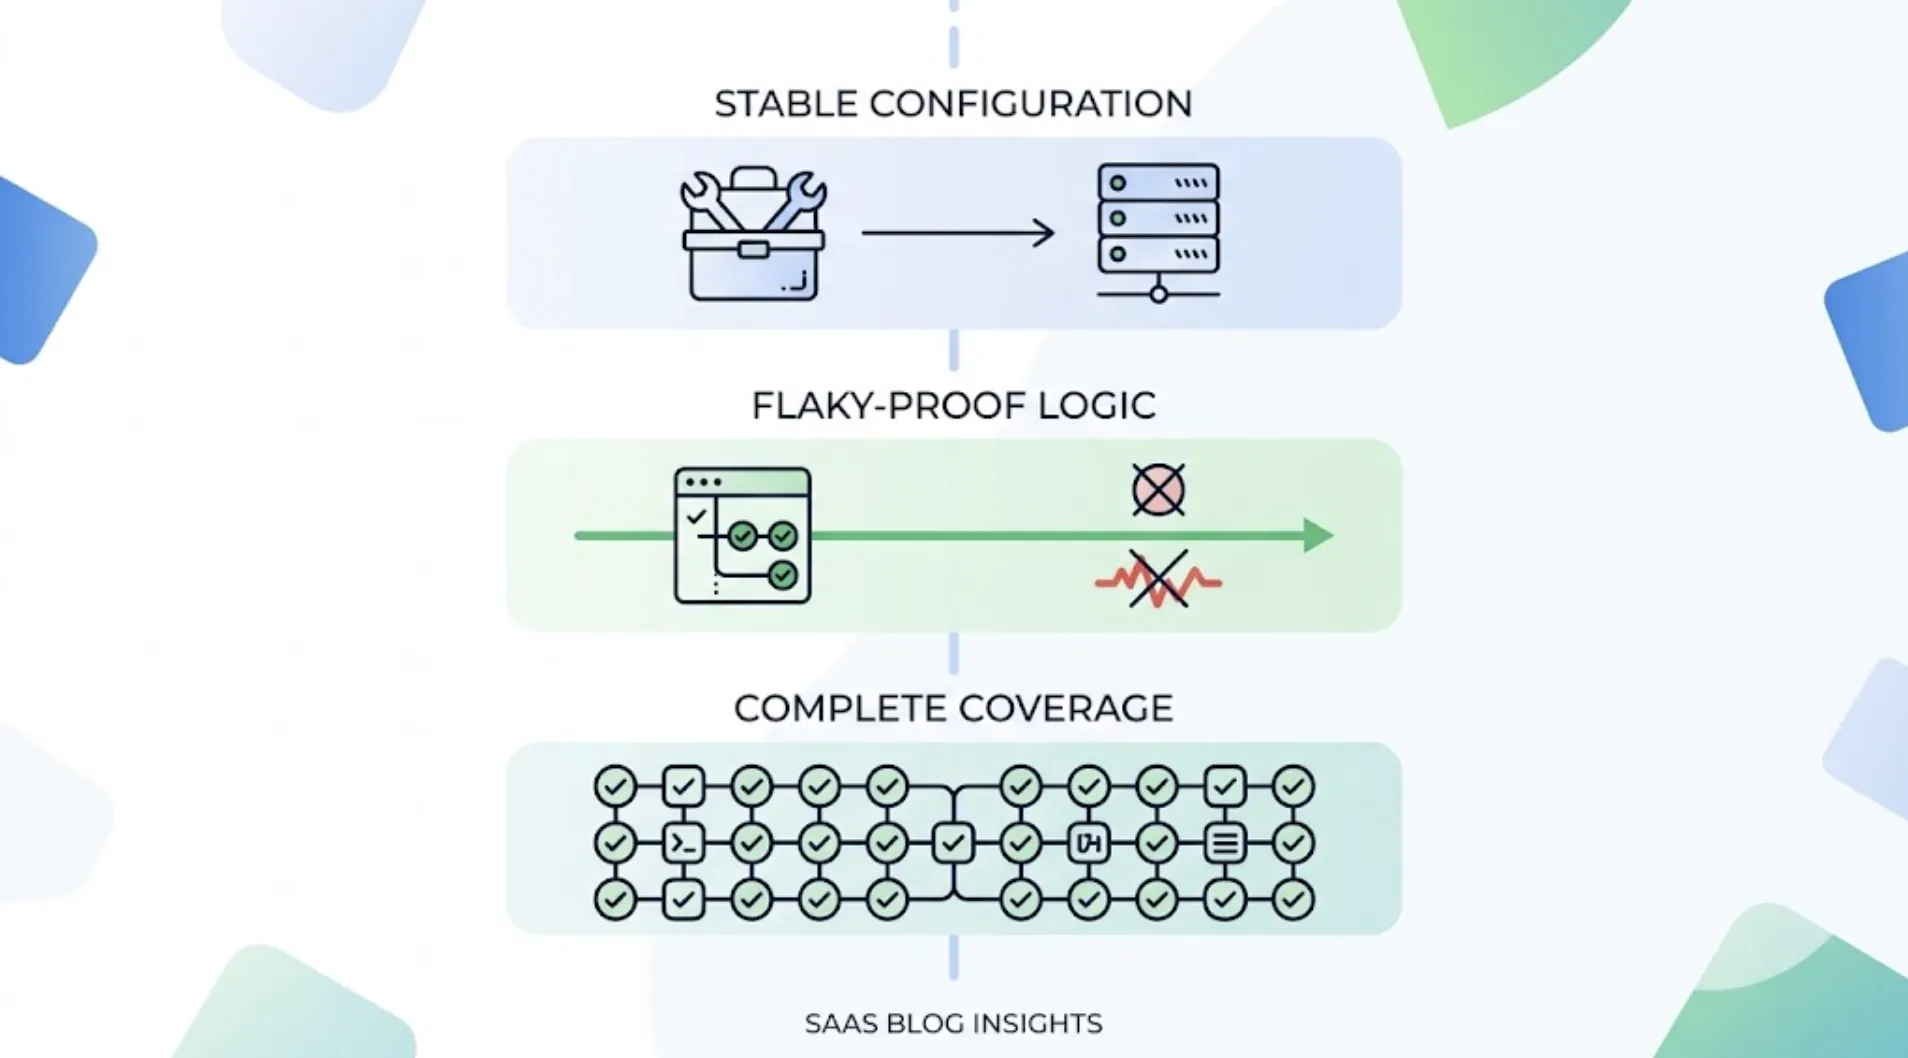
目標はシンプルです。自動テストを実際に動作するアプリケーションに対して実行しない限り、いかなるPRもマージされないことです。そのためには、3つの要素が個別にではなく連携して機能する必要があります。
すべてのPRイベントで発火するCIトリガー(最初のイベントだけでなく)。CIが実行するためのデプロイ済みプレビュー環境(ソースコードだけに対するテストではプロダクトレイヤーの不具合を検出できないため)。そして、レビュアーが別のダッシュボードを探しに行かなくても結果を確認できる仕組みです。
これらのうち一つでも欠けると、セットアップが完了しているように見えて、実際にはすべてのマージを保護できていない状態になります。
ステップ1:GitHub Actionsインテグレーションを接続する
TestSpriteのGitHub Actionsインテグレーションは、IDE内で使用されるのと同じテストパイプライン(探索、計画、生成、実行、分析、修復、レポート)を実行しますが、開発者の指示ではなくGitHubイベントによって自動的にトリガーされます。
他の検証ツールはコードを読んで推測します。TestSpriteはあなたのアプリを開いて実際に使います。
ワークフローファイルでは、実行をトリガーするイベントを指定します。PRを完全にカバーするには、`opened`と`synchronize`の両方でトリガーするよう設定します。これにより、PRが最初に作成されたときと、その後新しいコミットがプッシュされるたびに新たな実行が行われます。`opened`のみでトリガーするワークフローは、PRの最初のバージョンをテストするだけで、その後のすべての更新に対して沈黙します。これは、レビューフィードバックを経るすべてのPRにとって意味をなしません。
ステップ2:実際のプレビューデプロイメントに対して実行する
自動テストの実行は、何に対してテストするかによって価値が決まります。ローカルビルドやモック環境に対してテストしても、本番に近い環境でしか現れない不具合のクラスを見逃します。ローカルと異なる環境変数、テストフィクスチャではなくリアルなデータを持つデータベース、サービス間の実際のネットワークレイテンシなどがその例です。
多くのチームはすでに、Vercel、Netlify、Railwayなどのプラットフォームを通じてPRごとにプレビューデプロイメントを生成しています。GitHub Actionsワークフローは、静的ビルドではなく、そのプレビューURLをTestSpriteに指定する必要があります。このステップにより、チェックの内容が手動QAに近いものになります。PRがマージされた場合に実際にリリースされるものを検証するのです。
ステップ3:結果をPRコメントとして投稿するよう設定する
テスト結果が誰にも見られない状態では、行動は変わりません。このインテグレーションは結果をPRコメントとして直接投稿します。つまりレビュアーは、差分と並んで同じ場所でプロダクトレイヤーのテストカバレッジを確認でき、余計な手順は不要です。
この配置は、一見些細なようで実は重要です。意図的な操作が必要な別のダッシュボードは、チームが忙しくなるにつれて確認される頻度が低下します。PRコメントはすでにレビューフローの一部であるため、必ず目に入ります。
シナリオ:貨物ディスパッチツールが重複出荷バグを検出
物流スタートアップが、荷主が荷物を作成してキャリアに割り当てられるディスパッチツールを構築しています。荷物が割り当てられると、キャリアのシステムに通知するWebhookが送信されます。開発者はCursorを使ってWebhook呼び出しにリトライロジックを追加し、配信失敗時にサイレントに無視されるのではなく再試行されるようにしました。
PRは正しく見えます。リトライロジックが動作し、失敗したWebhook呼び出しが再送され、変更と合わせて書かれたテストも通過します。
GitHub ActionsワークフローがPRに対してトリガーされ、VercelプレビューデプロイメントにTestSpriteを実行します。探索エージェントがキャリアに荷物を割り当て、Webhookエンドポイントの応答が遅い状況をシミュレートします。これはまさにリトライロジックが対処するために作られた条件です。テストの結果、遅い応答が期待どおりリトライをトリガーすることが確認されましたが、元のリクエストもリトライ完了後に最終的に成功し、キャリアのシステムが同じ荷物割り当てを2回受信して重複出荷レコードが作成されることが判明しました。
レビューが始まる前にPRコメントが表示されます。どの荷物で、どのWebhookで、どの重複レコードが作成されたかが記載されています。レビュアーはコードの差分と並んでこれを確認し、下流で請求の不一致を引き起こす可能性のある変更を承認する代わりに即座にフラグを立てます。開発者はWebhookペイロードに冪等性キーを追加して修正をプッシュし、ワークフローが新しいコミットに対して自動的に再実行され、重複が発生しなくなったことが確認されます。
構造的なノイズを処理してゲートの信頼性を維持する
UIの変更のたびに誤検知を出すCIチェックは、チームにそれを無視するよう学習させてしまい、すべてのPRで実行する意義を損ないます。TestSpriteのAuto-Heal Rerun(Starterプランから利用可能)は、行動的な変更(PRが実際にプロダクトの動作を変えた)ではなく、構造的な理由(要素のリネームや位置変更など)で失敗するテストを適応させることでこれを処理します。偽の回帰としてフラグを立てることはありません。
実際の行動的な失敗は引き続き明確に表面化します。この区別こそが、チームがPRコメントを確認し続け、読み飛ばすことを学習しないための鍵です。
セットアップがすべてのPRをカバーしているかを確認する
設定が完了したら、意図的なテストでセットアップを検証する価値があります。何かが壊れることがわかっている変更でPRを開き、通常レビューを開始する前にコメントとして失敗が表示されることを確認します。表示されない場合は、まずトリガーイベントを確認してください。`synchronize`トリガーの欠落が最も一般的な不備です。
まとめ
すべてのプルリクエストに自動テストを実行させることは、ワークフローファイルを1つ追加するだけの話ではありません。すべての更新でトリガーが発火すること、実際のプレビューデプロイメントに対してテストが実行されること、そして結果がレビュアーがすでに確認している場所に届くことを確実にすることです。
TestSpriteのGitHub Actionsインテグレーションは、この3つすべてを処理します。プレビュー環境に対して探索からレポートまでの完全なパイプラインを実行し、結果をPRに直接コメントとして投稿します。
GitHub Actionsインテグレーションをセットアップして、リンターしか確認していないプルリクエストをマージし続ける状況をなくしましょう。