依存リクエストを持つステートフルAPIワークフローのテスト方法
 Rui Li
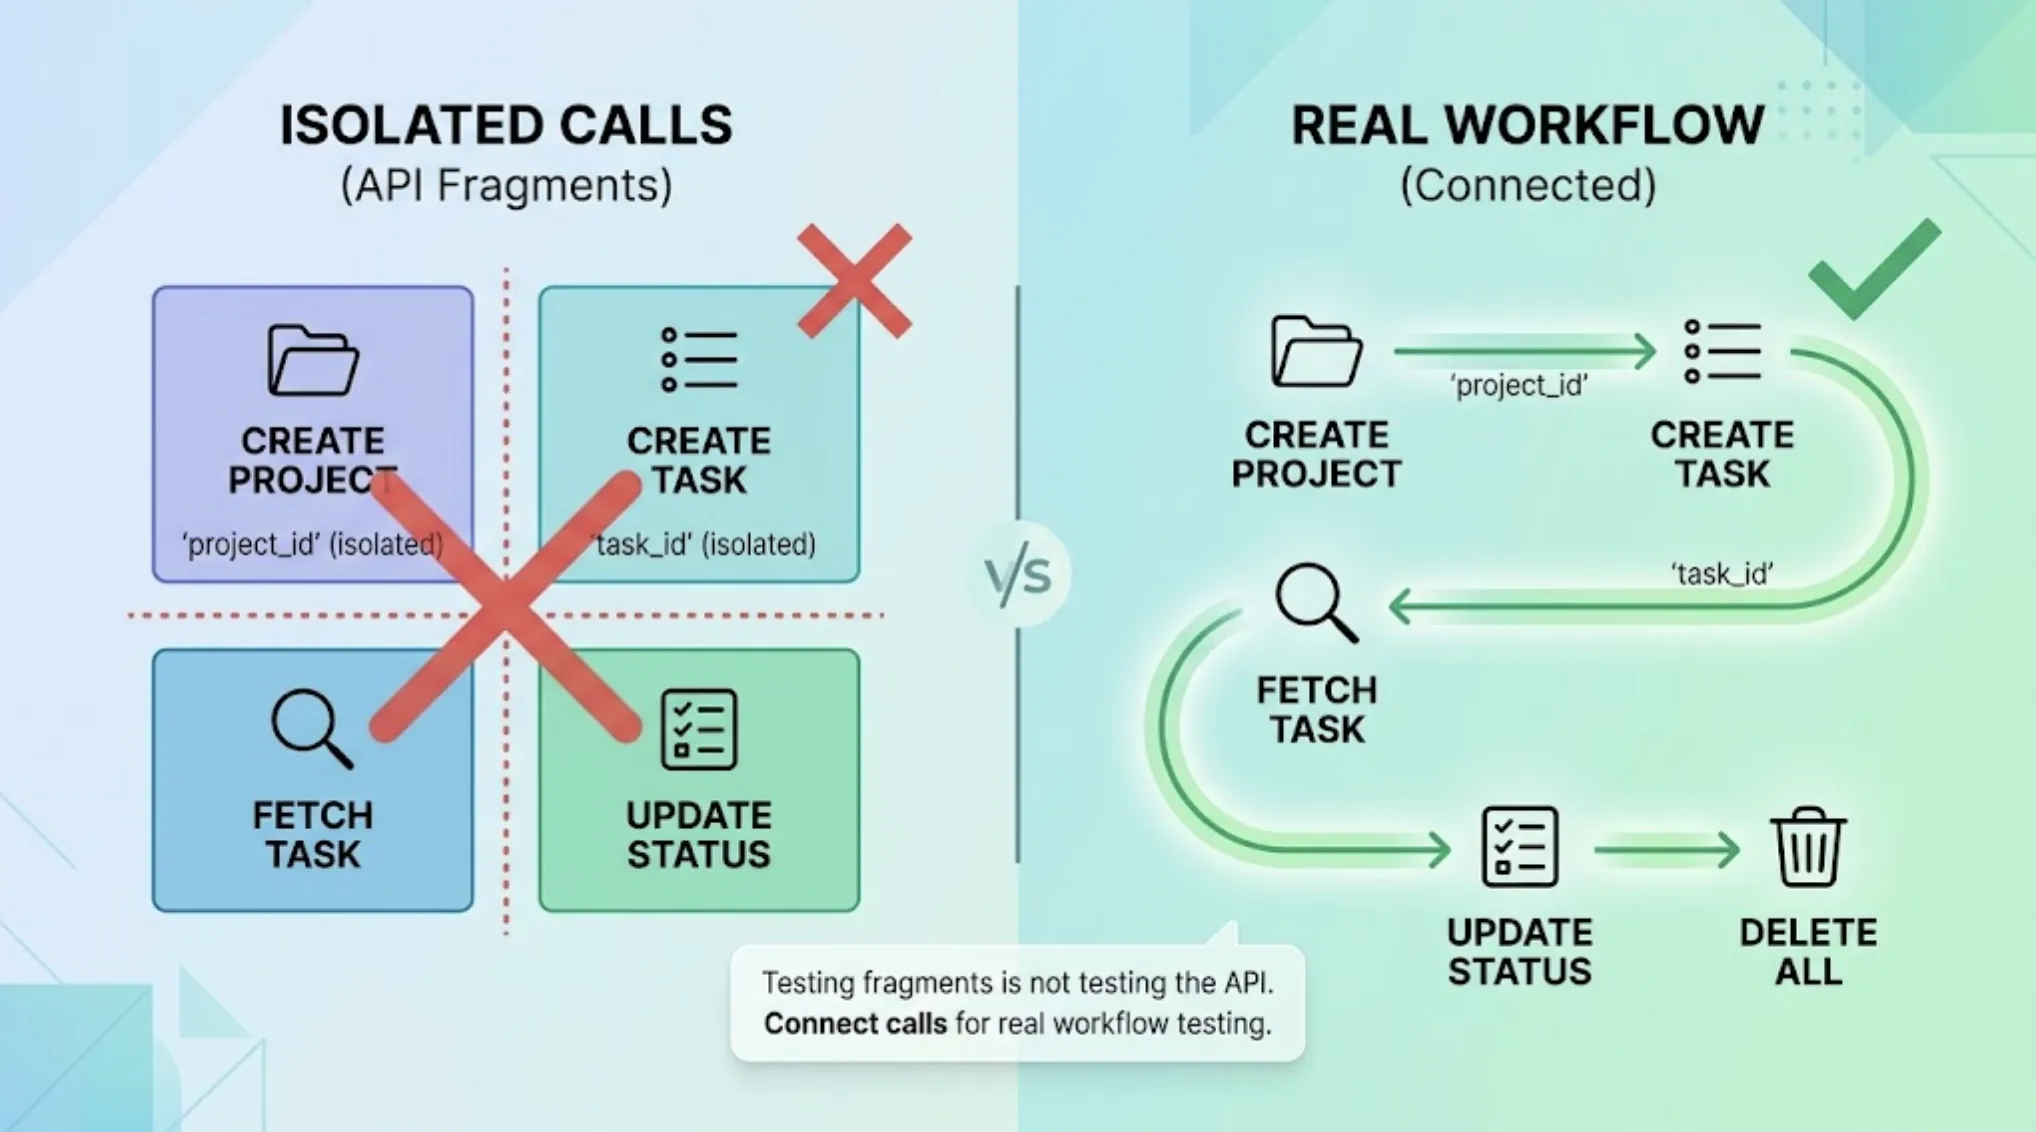
実際のAPIバグのほとんどは、単一のエンドポイントには存在しません。リクエスト間のハンドオフに存在します。ステップ1のトークンをステップ3が必要とすること、あるコールで作成されたリソースIDが3つ後のコールで参照されること、あるいは狭い時間ウィンドウでしか有効でない状態の一部。
優れたAPIテストツールはそのチェーンを自動的に処理できる必要があります。そうでなければ、テストする人が毎回手動で配線を行うことになります。それこそが、TestSpriteのBackend Testing 2.0が高速に出荷するチームのために排除するよう構築された摩擦です。
ステートレステストが実際のリスクを見逃す理由
各エンドポイントを独立してテストするのは簡単です。呼び出し、レスポンスを確認し、次へ進む。このアプローチは確かにあるクラスのバグ、不正な形式のレスポンス・誤ったステータスコード・フィールドの欠落、を発見します。しかし、エンドポイントが実際にシーケンスとして連携して動作するかどうかは確認できません。そこにこそ、より高コストなバグが実際に潜んでいることが多いのです。
注文を作成し、支払い方法に課金し、在庫を更新するチェックアウトフローは、複数のサービスが複数のコールにわたって互いに合意することを必要とします。それぞれを独立してテストしても、ステップ1の注文IDがステップ2の課金リクエストで実際に参照されているかどうかは何もわかりません。
TestSpriteが依存リクエストで行うこと
“他の検証ツールはコードを読んで推測します。TestSpriteはあなたのアプリを開いて実際に使います。”
MCP ServerまたはWebポータルを通じて、TestSpriteのバックエンドテストはあるレスポンスからプロジェクトID・認証トークン・リソース識別子などの実際の値をキャプチャし、シーケンスの次のリクエストに自動的に渡します。誰かがある値を手動でコピーして次のテストに貼り付ける必要はありません。
インテグレーションテストはさらに一歩進んで、複数ステップのシーケンスを自体で特定します。作成・読み取り・更新・削除を、関連データに触れる個別のコールのセットではなく、単一の実行可能なチェーンとして組み立てます。
ステートフルテストが実際に必要とするもの
想定値ではなく実際の値のキャプチャ。シーケンスの最初のリクエストが何かを返し、次のリクエストはその正確な値を必要とします。これは、仕様やドキュメントが返すと想定した値からではなく、APIが実際に返したものから来なければなりません。
手動の配線なしにその値を次へ渡す。キャプチャされたら、値は自動的に次のリクエストのパラメータまたはヘッダーに流れる必要があります。それこそが、独立したAPIコールのセットを実際のワークフローテストに変えるものです。
その後のクリーンアップ。ステートフルテストは実際のリソースを作成します。自動クリーンアップなしでは、毎回の実行で孤立したレコードが残り、最終的にテスト環境が汚染されて時間の経過とともに結果の信頼性が低下します。TestSpriteはスイートの終了後、依存関係の順序で実行が作成したリソースを削除するため、次の実行は廃棄物を蓄積するのではなくクリーンな状態から始まります。
シーケンス中に期限切れになる認証の処理。長い複数ステップのワークフローは、短命なトークンよりも長くなることがあります。Auto-Authは毎回の実行前にログイントークンを更新するため、期限切れトークンが実際に検証されている機能とは無関係な理由でテストを失敗させることはありません。
失敗をテスト全体ではなく特定のステップまで追跡可能にすること。6ステップのチェーンが失敗した場合、どのステップが失敗し何を受け取ったかを知ることは、チェーンが失敗したということを知るよりも重要です。最終的なパスまたはフェイルだけでなく各ステップのリクエストとレスポンスを示すレポートこそが、失敗を再実行して手動で調査しなければ理解できないものではなく、実行可能なものに変えます。
具体的なトレース例
サブスクリプションのアップグレードフローを例に考えてみましょう。顧客の作成、支払い方法の紐付け、プランのアップグレード、そして後続のアカウント照会で新プランが反映されているかの確認という流れです。4つの独立した呼び出しがあり、それぞれが前のステップで返された値に依存しています。これら4つのうちどれか1つを単独でテストしても成功するでしょう。しかし重要なバグ、つまりアカウント照会に新プランが実際に反映されないという問題は、ステップ間でリアルな値を引き継ぎながらチェーン全体を実行した場合にのみ表面化します。
ワークフローが長くなるほどこの問題が重要になる理由
2ステップのチェーンであれば、値の受け渡しを自動化しなくても比較的簡単に把握できます。引き渡しポイントが1つだけだからです。しかし6〜8の依存ステップを持つワークフローでは、そのリスクが累積していきます。引き渡しが増えるたびに、手動で設定した値が古くなったり、誤っていたり、完全に欠落したりする可能性が高まります。TestSpriteのデータフロービューは、チェーン内のすべてのHTTP呼び出しをエンドポイントごとにグループ化し、それぞれのリクエストとレスポンスを表示するため、長いシーケンスのどこで問題が発生したかを特定しやすくなります。全体を再実行して何が起きたかを推測する必要はありません。
この累積効果こそが、ステートフルなテストを初期にスキップしたチームが後々後悔する理由でもあります。2ステップのサインアップフローが、心配するほどの契約上の不一致を隠していることはほとんどありません。しかし同じプロダクトが6ヶ月後に、請求・権限・通知をまたいで十数の機能がチェーンされた状態になると、リスクプロファイルはまったく異なります。そうなってから事後的にこの種のカバレッジを追加するコストは、最初から組み込む場合よりもはるかに高くなります。
まとめ
APIの本当のリスクは、個々のエンドポイントの中ではなく、リクエスト間の接続部分に潜んでいます。リアルな値を取得し、自動的に次のステップへ受け渡し、テスト後にクリーンアップすることが、本物のワークフローテストと、同じ機能を触るだけの孤立した呼び出しの集合とを区別するものです。
TestSpriteはバックエンドテストの一部として、このチェーンを自動的に処理します。ご自身のAPIの複数ステップのフローで無料でお試しいただき、シーケンス全体で何が検出されるかをご確認ください。多くのチームにとって、最初にテストするチェーンは、すでに最も自信が持てなかったものであることが多く、それには十分な理由があります。
チェーンが断続的に失敗し続ける場合に確認すべきこと
複数ステップのチェーンにおける断続的な失敗は、通常3つの原因のいずれかを示しています。上流のリソースが完全にコミットされる前に下流の呼び出しが実行されるレースコンディション、長いシーケンスの途中で期限切れになるトークンやセッション、またはAPIが実際には保証していない実行順序への依存です。フレイキーと切り捨てるのではなく、失敗を一貫して再現する努力は十分に価値があります。これら3つの原因にはそれぞれ異なる修正方法があり、根拠なく原因を推測すると、実際の失敗ステップを追跡するよりも多くの時間を無駄にすることになります。