毎日リリースするアプリでリグレッションテストの対象を決める方法
 Rui Li
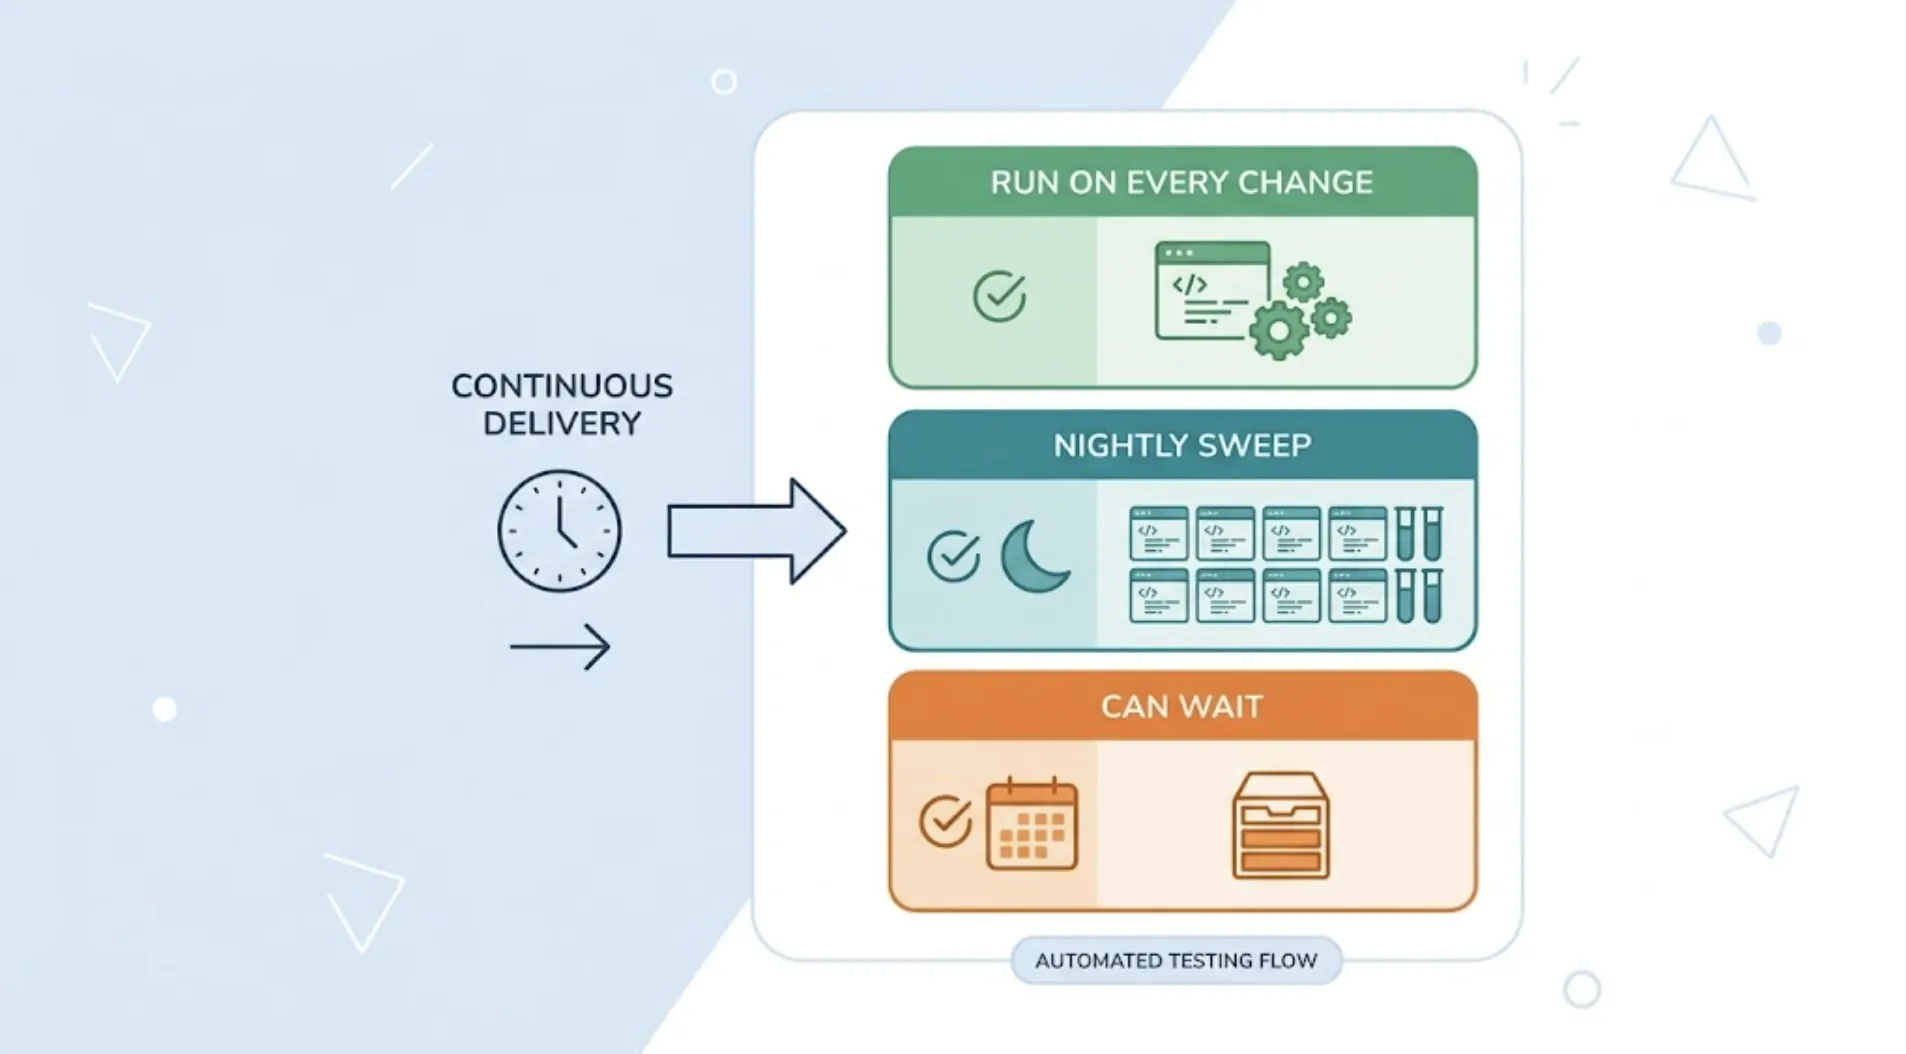
1日に何度もリリースするチームは、テストスイートがそもそも防ぐべきボトルネックになることなく、毎回すべてのリグレッションテストを実行することはできません。本当の問題はリグレッションテストを実行するかどうかではありません。何を夜間スイープに含め、何を毎回の変更でテストし、何を後回しにできるかを判断することです。
「すべてを、毎回テストする」がスケールしない理由
あらゆる変更に対してすべてのリグレッションスイートを実行することは、一見最も安全な選択肢に思えます。しかし実際には、日々のリリース速度の中で、それはチームを守るものではなく、チームが迂回するものになってしまいます。
長時間かかるスイートは、日々のリリースを可能にしたフィードバックループそのものを遅らせます。フルリグレッションの実行に40分かかり、チームが1日に5回リリースする場合、スイートがバックグラウンドで常時実行されてキューの遅延が生じるか、急いでいる誰かがスキップするかのどちらかです。後者では、そもそもの目的が果たせません。
解決策は、検出できる問題を減らした小さなスイートではありません。実際のサイクルに沿って構造化されたスイートです。つまり、プロダクトの各部分が実際にどれほどリスクが高く、どれほど頻繁に変更されるかに合わせて、異なるスコープを異なる頻度で実行することです。
リグレッションカバレッジの3つの層
第1層:コアフロー、すべての変更でテスト。サインアップ、ログイン、チェックアウトなど、サイレントに壊れたら致命的な3〜5つのフロー。これらはセッション内トリガー「Help me test this project with TestSprite」を通じて、それらに近い部分に触れるすべてのAIコーディングセッションの終わりに実行され、さらにGitHub Actions連携によってすべてのプルリクエストでも実行されます。
他の検証ツールはコードを読んで推測します。TestSpriteはあなたのアプリを開いて実際に使います。
第2層:現在開発中のエリア、毎日テスト。チームが現在構築中のプロダクトの部分は、そのエリア内のフローをコアフローチェックよりも詳細にカバーする、フォーカスされた深いパスを1日1回実施します。ここに、Webポータルを通じたTestSpriteのスケジュールリグレッション実行が適合し、活発に開発中の特定の機能エリアに向けて設定されます。
第3層:プロダクト全体のサーフェス、より長いサイクルでテスト。活発に変更されていないエリアも定期的な検証が必要です。コードベースの別の箇所での変更が、誰も直接触れていないプロダクトの部分を壊す可能性があるためです。週1〜2回のフルスイープにより、すべての変更ごとにスイート全体を実行することなく、このカテゴリの問題を検出できます。
変更頻度に合わせてテスト頻度を調整する(その逆ではなく)
すべての部分を同じ頻度でテストしたいという直感は、プロダクトのすべての部分が同様にリスクを持つと考えることから来ていますが、実際にはそうではありません。何ヶ月も変更されていないが実際のお金を扱う決済フローは、変更頻度に関わらず頻繁なテストが必要です。一方、常に変更されるが3人の社員にしか影響しない社内管理パネルは、軽いサイクルでも許容できます。
プロダクトの各部分に対して問うべき適切な質問は、2つの要素の組み合わせです。このエリアはどれくらいの頻度で変更されるか、そしてこのエリアがサイレントに壊れた場合にどれほど深刻か。両方が高ければ第1層。どちらか一方が高く他方が低ければ第2層。両方が低ければ第3層で十分です。
シナリオ:フィットネスクラス予約アプリがテストサイクルを再構築する
フィットネススタジオ予約アプリを開発しているチームは、すべてのマージにフルリグレッションスイートを実行していましたが、十分に遅くなったため、開発者たちは完了を待たずにマージし始め、その後の赤い結果はユーザーからクレームがあった場合にのみ調査するものとして扱うようになっていました。
彼らは3層アプローチを中心に再構築しました。クラスの予約、キャンセル、支払いは第1層となり、GitHub Actionsを通じてすべてのPRでテストされ、これらのフローに触れるすべてのコーディングセッション後にもテストされます。そのクォーターに積極的に再構築していたウェイトリスト機能は第2層となり、毎朝Webポータルを通じてフォーカスされたスケジュール実行が行われます。インストラクタープロフィール管理とスタジオ設定は、どちらも安定していて変更が少ないため、週2回の第3層スイープに移行しました。
第2層のウェイトリストテストは最初の1週間以内にレースコンディションを検出しました。スポットが空いて2人のウェイトリストメンバーに同じ秒内に通知が送られた場合、両者がそれを確保でき、クラスが1名オーバーブッキングになる問題です。従来のオールオアナッシングスイートでは、すべてのマージで実行される数十の無関係なチェックの中に埋もれ、ノイズの中で見落とされやすかったでしょう。活発に開発中の特定エリアへのフォーカスした日次実行では、それが唯一詳しくチェックされる対象であり、即座に表面化しました。
修正は、単純な可用性読み取りの代わりに適切なクレームロックチェックを使用しました。第2層の実行が翌朝それを確認しました。
Auto-Healで頻繁なテストのコストを削減する
コアフローをすべての変更でテストし続けることが持続可能なのは、無関係なUI調整による誤検知アラームが常に発生しない場合に限られます。Starterプランから利用可能なTestSpriteのAuto-Heal Rerunは、変更が動作的ではなく構造的なもの(要素のリネームや移動など)である場合に、それをリグレッションとして検知することなくテストを自動的に適応させます。
これは通常、ビジュアルリグレッションテストと呼ばれるものと重なります。インターフェースの見た目や構造への意図しない変更を検出します。Auto-Healは典型的なビジュアルdiffよりも一歩進んでいます。画面上の何かが変わったことを検知するだけでなく、実際に報告するかどうかを決定する前に、コスメティックな変更と実際の動作上のリグレッションを区別します。
これが、日々のリリース速度での第1層テストを実現可能にする要素の一つです。頻繁なチェックはシグナルとしての役割を維持し、ノイズにはなりません。それが、チームが結果を実際に確認し続けるために信頼し続けられる唯一の方法です。
まとめ
日々のリリース速度でのリグレッションテストは、1つのスイートをより多く、またはより少なく実行することではありません。プロダクトの各部分が実際にどれほどリスクが高く、どれほど活発に開発されているかにテスト頻度を合わせることです。それにより、最も重要なフローは常にチェックされ、安定した低リスクのエリアは誰のスピードも落とさないサイクルでチェックされます。
TestSpriteは、即時チェックのためのセッション内トリガー、すべてのPRに対するGitHub Actions、そしてカバレッジを補完する日次・週次スイープのためのWebポータルを通じたスケジュール実行によって、これをサポートします。
TestSpriteで段階的リグレッションテストを設定し、高速なリリースと徹底的なテストのどちらかを選ぶ必要をなくしましょう。