QAチームなしでフルスタックのテストカバレッジを構築する方法
 Zeshi Du
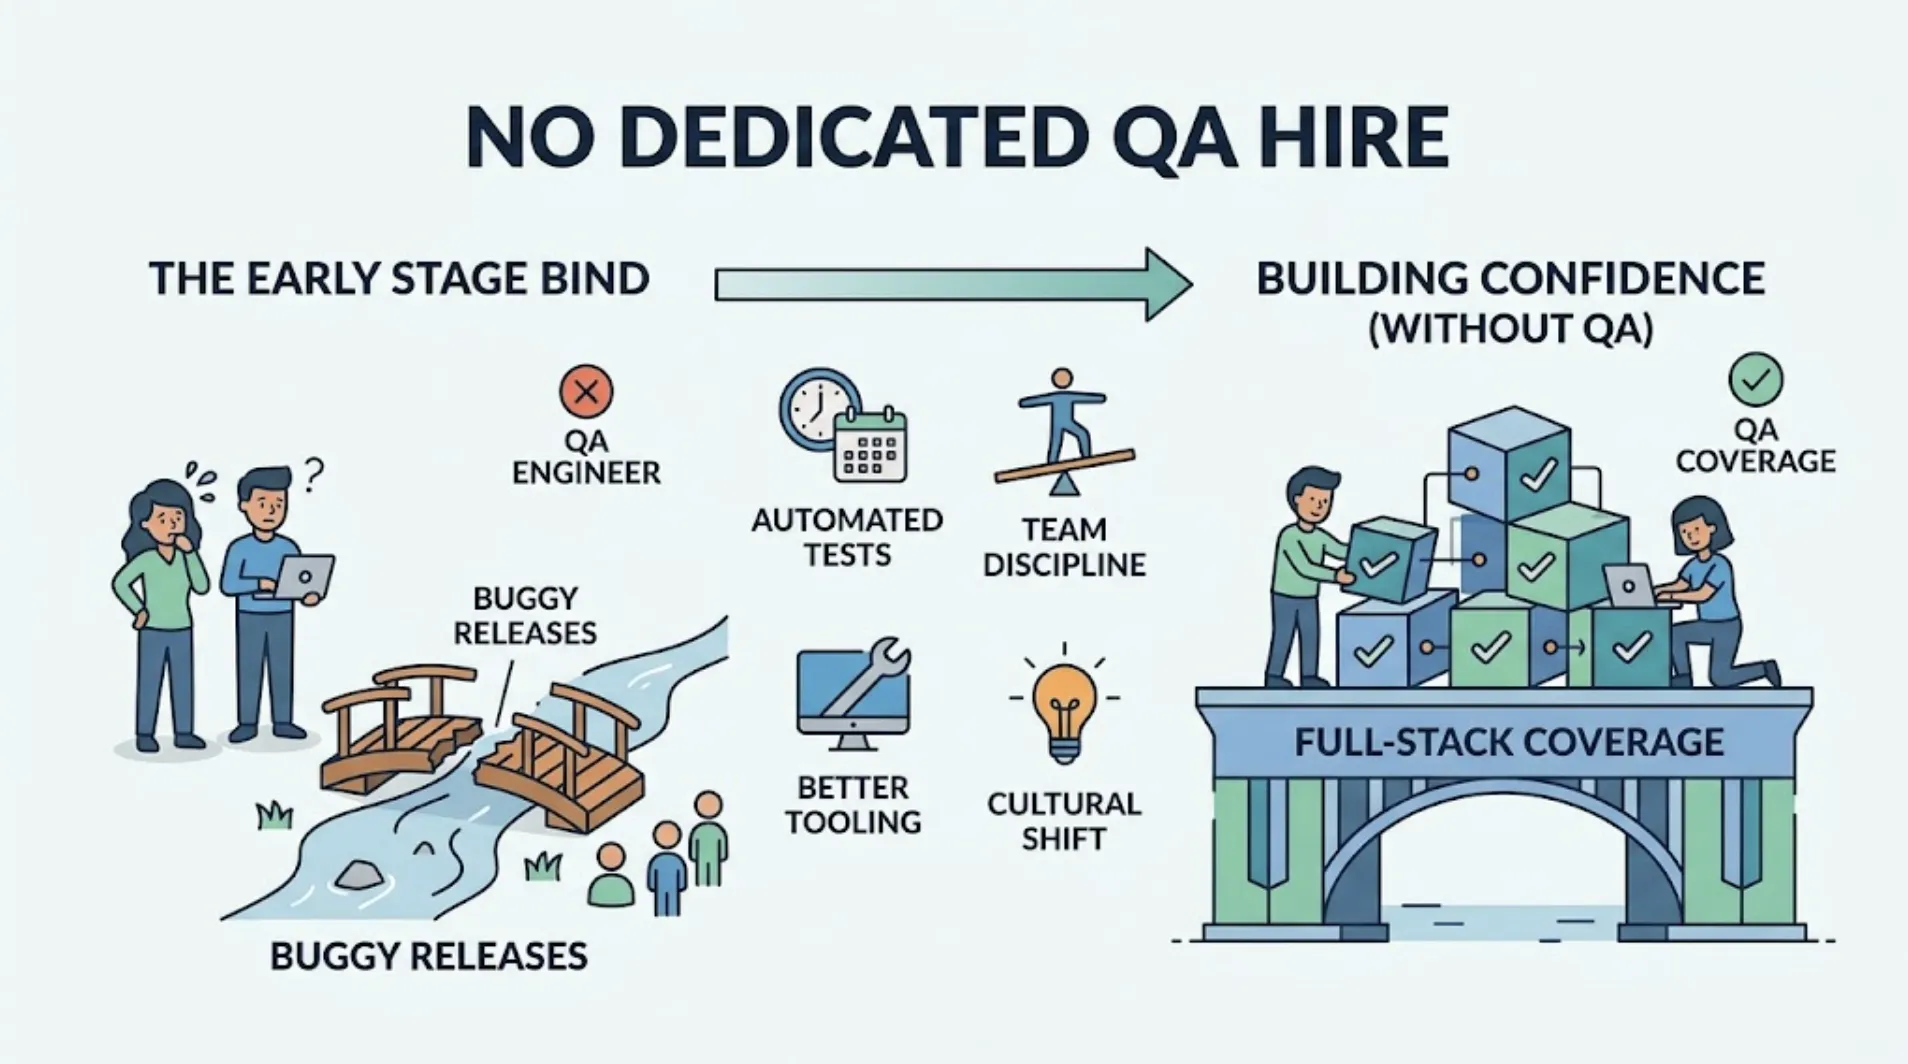
小規模チームは特有のジレンマを抱えています。QAエンジニアの採用は初期段階では費用対効果が合いませんが、何の検証もなくリリースを続けると本番環境がQA環境と化し、バグをユーザーが発見することになります。
専任のQA採用なしに真のフルスタックカバレッジを実現する方法と、それでもなお自分たちに求められることを解説します。
QAを採用しない場合、テストの責任は誰が担うのか
QA機能が存在しない場合、テストの責任がなくなるわけではありません。それは静かに、機能を実装した担当者へと集約されます。
誰もそう名指ししなくても、これは利益相反です。変更をリリースしたエンジニアが、デッドラインを抱えながら、かつ最も客観的な視点を欠いた状態で、その変更の安全性を判断する立場に置かれるのです。
手動テストは、本来開発に充てるべき時間を消費します。そのため短縮されがちです。ハッピーパスを一度だけクリックして確認し、実際に本番で問題を起こすもの(期限切れのセッション、ダブルクリックによる競合状態、順序が乱れた決済Webhook)は、リリース前にすべてのエッジケースを考える時間がないため、スキップされます。
結果は「慎重に対応したのでバグなし」ではなく、実際のユーザーが最初にバグに遭遇し、その後に深夜の修正対応が発生し、こうした事態が繰り返されるたびにロードマップが少しずつ遅れていく、というものです。
これは採用基準を上げたりチェックリストを改善したりして解決できる人材の問題では、本質的にありません。ワークロードの問題です。同じデッドラインの下で、同じ変更の実装者と客観的な検証者を一人の人間が兼ねることはできないのです。これがTestSpriteのような自律型テストエージェントが埋めるために設計されたギャップです。その仕組みに入る前に、「フルスタック」カバレッジに何が含まれなければならないかを理解することが重要です。
「フルスタック」カバレッジに実際に含まれなければならないもの
真のフルスタックカバレッジとは、テストしやすい層だけでなく、フロントエンド、バックエンド、そしてその間のコントラクトすべてが検証されることを意味します。
- フロントエンドUIフロー:サインアップからコア機能ループ、課金に至るまでの実際のユーザー向けパス。
- バックエンドAPI:それらのフローが呼び出すエンドポイントを、想定ではなく実際の返り値に基づいて検証する。
- 認証:ログイン、セッション管理、トークンのリフレッシュ。認証フローが壊れると、その下流のすべてがブロックされます。
- エラー処理とエッジケース:決済の失敗、期限切れのセッション、不正な入力形式。これらはまさに、簡易的な手動確認がスキップしがちなバグのカテゴリです。
- フロントエンドとバックエンド間のコントラクト整合性:2つの層がリクエストおよびレスポンスの形式について実際に合意しているかどうか。これは多くの実際のバグが潜む領域であり、どちらか一方の層だけをテストする方法では、構造的に検出できません。
これらの問題は手動の努力を増やすことでは解決できません。小規模チームには、テスト計画の立案、スイートの作成と保守、機能のリリースに加えて障害のトリアージまで担当する余裕のある人員はいません。これがTestSpriteが実際に役立つ領域です。
自律型テストエージェントの役割
TestSpriteは自律型AIテストエージェントです。設定後も自分で運用し続けなければならないフレームワークではありません。専任採用が必要だった作業、すなわちテスト計画、テスト作成、実行、レポートを引き受け、あなたはゼロから作成する代わりに出力をレビューするだけで済みます。
出発点は空のテストファイルではなく、プロダクトの意図です。PRDがあればTestSpriteはそれを解析します。なければ、MCPサーバーがIDE内から直接コードベースを読み取り、テストを1件も書く前にプロダクトが何をすべきかをリバースエンジニアリングします。サイクル全体をトリガーするには、「このプロジェクトをTestSpriteでテストしてください」という一文のプロンプトで十分です。
“他の検証ツールはコードを読んで推測します。TestSpriteはあなたのアプリを開いて実際に使います。”
この違いは、手動テストが小規模チームで機能しなくなる正確な理由において重要です。現在のコードがたまたま行っていることではなく、プロダクトが本来すべきことに基づいて設計されたテストスイートは、今日のバグを明日の「期待される動作」に静かに変えてしまいません。発見、計画、生成、実行、分析、修復、レポートという完全なループが実行されるため、各段階を監視する代わりに、完成したサイクルをレビューするだけで済みます。
チームがソロのIDE作業と共有ダッシュボードでのランの共同レビューを組み合わせている場合も、それはTestSpriteのユースケースが想定している正確な分業形態であり、どちらか一方を選ぶ必要はありません。
1つのソースから両方の層を生成する(個別ではなく)
小規模チームが手動でこれを行う際によくある落とし穴は、フロントエンドとバックエンドのテストを別々のプロジェクトとして扱うことです。「フロントエンドは今四半期、バックエンドはいずれ」という考え方が、リスクの半分を何ヶ月も未対処のまま放置することになります。
同じ要件ソースから両方を生成することで、その優先順位付けの問題が完全に解消されます。バックエンド側では、TestSpriteのAPIテストはドキュメントからレスポンスの形式を推測するだけではありません。アサーションを書く前に、実際のステータスコードや実際のフィールド名など、ライブAPIの実際のレスポンスを最初に観測します。これが、生成されたテストが実際には壊れていないものに対して失敗しないようにする仕組みです。
マルチステップフローも、QAエンジニアがマッピングするのと同じ方法でカバーされます。TestSpriteのインテグレーションテストは、作成・読み取り・更新・削除といったシーケンスを自動的に識別し、1つのワークフローにチェーンして、あるステップからオーダーIDのような値を取得し次のステップに渡します。
独自インフラを構築せずにテストを実行する
QAチームは通常、テスト環境とCIインテグレーションも管理します。そのチームがなければ、その管理責任をどこかが担わなければならず、自分で構築することは他のすべての作業に加えて別のプロジェクトになってしまいます。
テストは、数秒で起動し、隔離された状態を保ち、完了後に自動的に削除される安全な一時クラウドサンドボックスで実行されます。設定が必要なローカル環境も、実行間で管理すべきものも存在しません。
何かが失敗した場合、レポートには具体的なステップ、スクリーンショットまたは録画、および根本原因が含まれ、コーディングエージェントが直接対応できる形式で構造化されています。これにより、最後の段階で通常途切れるループが閉じられます。単に何かが間違っていると伝えるレポートではなく、失敗情報と修正提案が、最初にその変更を加えたコーディングエージェントへと直接フィードバックされます。
「誰かが覚えているとき」ではなく、スケジュールに基づくリグレッションテストはMonitoringが担当し、関連するテストを1つのTest Listにグループ化することで、スケジュール実行が10個の個別実行ではなく1回のパスで重要な項目をすべてチェックできます。
あなたが引き続き責任を持つこと
これは、テストに人間の関与がまったく不要になることを意味するわけではありません。QAチームなしでフルスタックカバレッジを実現するには、誰か、おそらくあなた自身が、カバレッジが現在の優先事項を実際に反映しているかどうかを定期的に確認する必要があります。
小規模チームに適したリズムとして、毎週軽くチェックし(明らかにおかしな点がないか、新機能のカバレッジが不足していないか)、月次または大きなリリース前により徹底的なレビューを行う(カバレッジが、PRDを書いた時点ではなく、現時点で最も重要なことと一致しているか)という方法があります。月に30分あれば通常は十分です。これを完全に省略することで、カバレッジがいつの間にか陳腐化していきます。
テストが存在しているにもかかわらずバグが本番環境に流出した「ニアミス」が発生した場合は、次回のスケジュールされたレビューを待たずに、臨時レビューのトリガーとして扱ってください。通常、PRDが要件を明確に捉えていなかったか、まだ誰も指摘していない新たなリスク領域が生まれたかのいずれかを意味します。どちらもすぐに修正する価値があります。
まとめ
QAチームなしでのフルスタックカバレッジは、かつて専任の採用が必要だった作業、つまりテストの計画・作成・実行・トリアージが、実際のプロダクトの意図に基づいたエージェントに移行し、ゼロからすべてを作成するのではなく結果をレビューするだけでよくなれば、現実的に実現できます。
TestSpriteは、まさにこのような状況のために設計されています。QA部門を持たずに高速でリリースしながら、スタック全体にわたる真のカバレッジを必要としているチーム向けです。無料で始められ、IDEまたはダッシュボードから15分以内に最初のプロジェクトを実行できます。