テストレポーティングとAIテストフィードバックループの違いとは?
 Zeshi Du
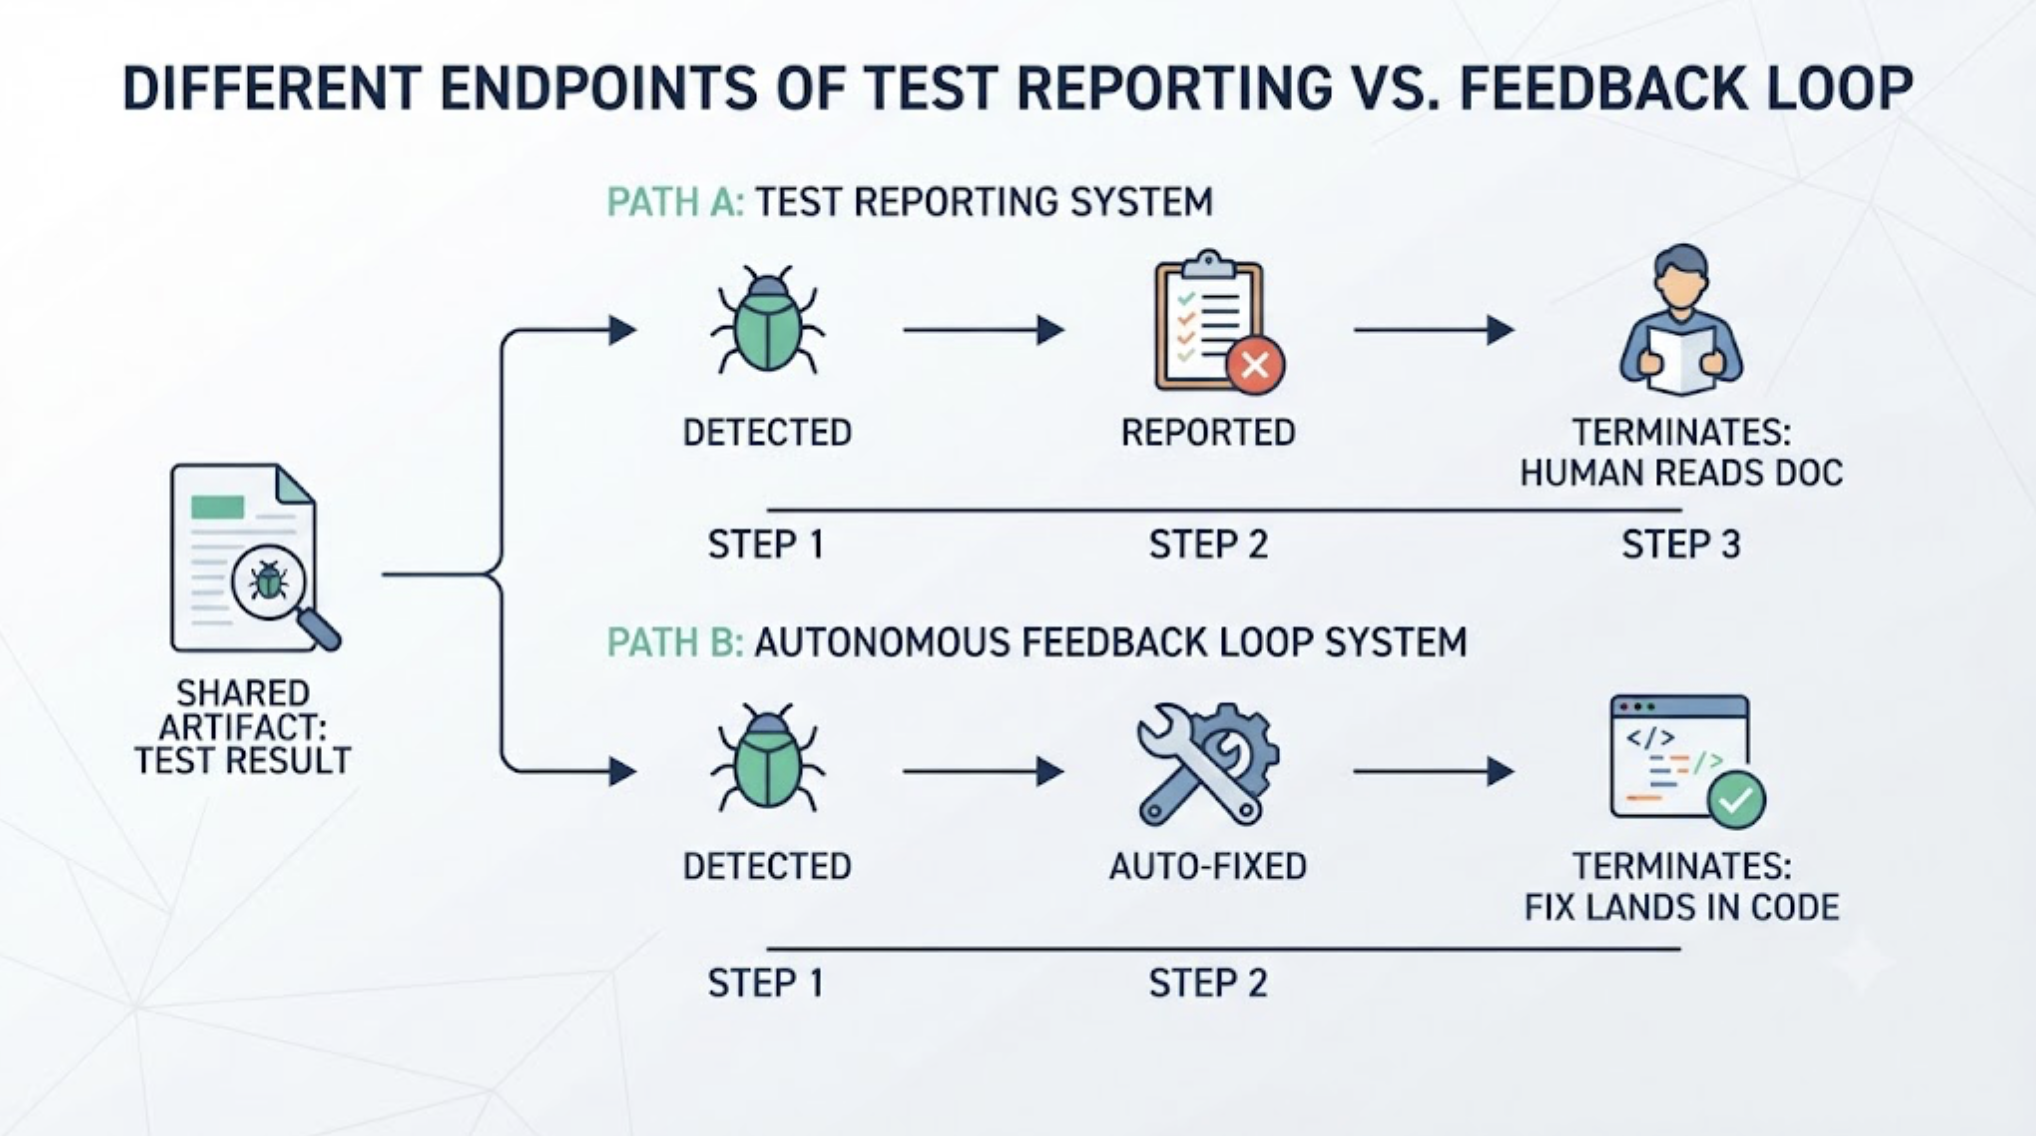
テストレポーティングは何が起きたかを伝えます。フィードバックループは次に何が起きるかを変えます。両者は同じ成果物(テスト結果)から始まるため混同されますが、異なるエンドポイントを持つ異なるシステムです。一方は人間がドキュメントを読むことで終わり、もう一方は修正がコードに着地することで終わります。
この区別は、同じバグを両方のレジームで測定して「検出」から「解決」までのステップを数えるまで抽象的に聞こえます。その数こそが全ての違いであり、ここで各システムをステップごとに説明し、ステップがどこで消えるかを示します。
テストレポーティングとは何か
レポーティングはテストの情報配信の半分です。結果を収集し、フォーマットし、提示します。合格率のダッシュボード、スタックトレース付きの障害リスト、トレンドチャート、メールのサマリー、ステークホルダー向けのPDFエクスポート。
優れたレポートには真の価値があります。品質は向上しているか、どのエリアで最も障害が発生しているか、先のスプリントの修正は維持されているかといったアカウンタビリティの問いに答え、コードなしで全体像を必要とするオーディエンス——リード、PM、クライアント——にも対応します。TestSprite自身がこの層、実行履歴、品質トレンド、"前回との変化"ビューに投資しているのは、全体像が重要だからです。
しかし、レポートの役割が終わる場所に注目してください:人の目に届いた時点です。その後の一切——障害を理解し、再現し、原因を特定し、修正を書き、検証する——は、レポートが単に起点となるだけの別プロセスです。レポートは終端的な成果物です。アクションはその対象外です。
フィードバックループとは何か
フィードバックループとは、検出、診断、修復、確認が一つのフローとして繋がり、業務が許す限り人間の中継地点を最小化した完全な回路です。
TestSpriteのループはこのように機能します。探索エージェントが検出を行います:実際のユーザーのように動作中のプロダクトを操作し、動作上の障害を発見します。
他の検証ツールはコードを読んで推測します。TestSpriteはあなたのアプリを開いて実際に使います。
発見物自体が診断であり、プロダクトの言葉で記述されます。どのフローか、どのアクションか、本来何が起きるべきだったか、実際に何が起きたかが示され、人間が読むためだけでなく、機械によるアクションのために構造化されています。MCP Serverを通じて、コードが書かれたのと同じClaude CodeまたはCursorのセッションに届き、完全な実装コンテキストを持つコーディングエージェントが修復を提案します。次の実行で修正が確認され、その確認は記録に加わります。
検出から解決まで、一つのセッション内で、人間はリレーするのではなくレビューする立場で関与します。これがループであり、「ループ」という言葉は実質的な意味を持っています:テストの出力がコーディングの入力へとフィードバックされ、コードが動く速度で自動的に行われます。
中継地点:レポート主導の体制が時間を失う場所
一つの障害について両者を並べてみると、その違いはホップ(中継)の一覧として表れます。
レポート主導の体制では:障害がダッシュボードに表示され、誰かが今日か木曜日に気づき、スタックトレースを読んでプロダクトの症状に翻訳し、ローカルで再現し、チケットを起票し、チケットが優先順位付けされ、開発者が引き継いで元のセッションが持っていたコンテキストを再構築して修正を書き、誰かが最終的に確認します。各ホップは時間を消費し、さらに悪いことに、各ホップでコンテキストが失われます——木曜日に修正する開発者は、月曜日のセッションが知っていたことをもはや把握していません。
ループ主導の体制では:発見物は、コンテキストがまだ生きているターミナルに届き、変更を書いたコーディングエージェントがプロダクトレベルの説明を読み、コンテキストが蒸発する前に修正が行われます。ホップが速くなるのではありません。ホップが削除されるのです。
AIコーディングが差を決定的にした理由
レポート中心のテストは、コードが人間の速度で動いていた頃は許容できました。コンテキストの劣化が遅かったからです——月曜日の変更を書いた開発者は木曜日にもまだそれを覚えていました。
AIコーディングは劣化速度を変えました。Claude Codeセッションのコンテキストは終了直後の数分間が最も豊富で、次のセッションまでにほぼ失われます。毎日複数のセッションを実行するチームは、チケットリレープロセスが処理できるよりも速く障害を生み出します。そのような状況では、レポートで終わるテストシステムはバグの解決が遅くなるだけでなく、流入量がリレーを上回るためバグが蓄積されます。
ループはこの代謝速度に合致しています:発見物はセッション速度でコンテキストを持つエージェントへと返り、バックログが形成されることはありません。レポートは依然として付随します——Portalの履歴とトレンドがループの実績を記録しますが、その記録はエンジンではなく排気です。
シナリオ:一つのバグ、二つの時計
4人チームがメールキャンペーンビルダーを運用しています。火曜日の朝、Claude Codeセッションでオーディエンスセグメンテーションロジックが改修されます。
旧来の体制では、結果はスタンドアップでレビューされるダッシュボードに流れていました。水曜日のスタンドアップでキャンペーン送信の赤いテストが浮上し、担当エンジニアはアサーション失敗を読み、1時間かけて再現し、症状を発見します:保存済みセグメントを対象としたキャンペーンが全リストに送信されていた。改修されたセグメントリゾルバーがレガシーセグメントに空のフィルターを返し、空はすべてを意味するためです。水曜日にチケット起票、木曜日に火曜日のコンテキストを再構築したエンジニアが修正、金曜日に確認。3日間の間に2つの実際のキャンペーンが全リストに送信され、2人の顧客の配信解除率がそれを物語っていました。
ループでは、同じ火曜日のセッションが一つの指示で終わります。エージェントは顧客のようにキャンペーンを作成し、保存済みセグメントをターゲットにし、テストバッチを送信し、受信者数を確認します——それが全リストです。発見物はまだ開いているターミナルに届きます:どのセグメントが選択されたか、カウントが何を示したか、何であるべきだったか。コーディングエージェントはリゾルバーの改修をコンテキストとして持ちながら、昼前にレガシーセグメントのパスにパッチを当て、再実行が火曜日の午後にそれを確認します。キャンペーンの誤送信はゼロでした。
同じバグ、同じ検出能力。違いは、検出後にシステムが何をしたかです。
まとめ
テストレポートは情報を届けます:人間が読むためにフォーマットされた結果で、ダッシュボードかインボックスで終わります。AIテストフィードバックループは解決を届けます:アクションのために書かれた発見物が、コンテキストとともにセッションへと返され、コーディングエージェントによって修復され、次の実行で確認され、レポートは記録として付随します。
どちらにも存在意義があり、AIが生成するコードのペースに追いつけるのは一方だけです。なぜなら、ループはレポート主導の体制が時間とコンテキストを失う中継地点を削除するからです。
TestSpriteで次のセッションのループを閉じましょう。無料プラン、クレジットカード不要。