APIテストツールとエビデンスに基づくバックエンドテストエージェントの違いとは?
 Zeshi Du
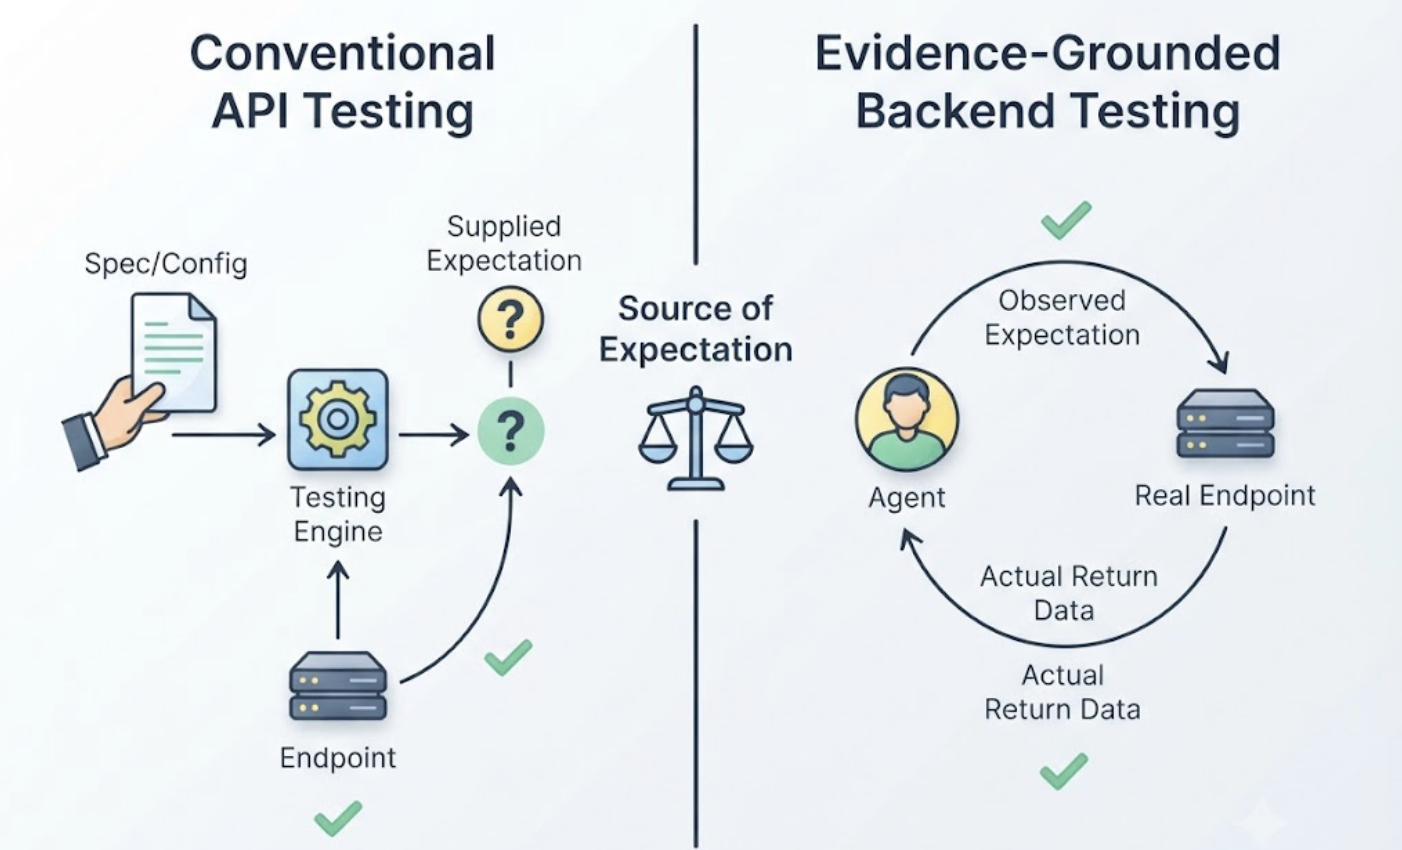
すべてのAPIテストには期待値が含まれる——このエンドポイントはこのステータス、このフィールド、この形式を返すべきだという期待だ。この質問における2つのカテゴリの違いは、すべて1点に集約される。その期待値がどこから来るか、という点だ。
従来のAPIテストツールでは、期待値は与えられるものだ。人間が設定し、仕様が宣言し、あるいはAIがソースコードから推測する。エビデンスに基づくバックエンドテストエージェントでは、期待値は観察されるものだ。エージェントはまず実際のエンドポイントを呼び出し、実際に返ってくる内容を記録し、そのエビデンスから検証を構築する。
この起源の違い1つが、信頼性、メンテナンス性、障害時の診断においてそれぞれ異なる結果をもたらす。以下に、その連鎖をステップごとに説明する。
APIテストツールが期待値を調達する方法
従来のAPIテストツールは期待値を実行するマシンであり、その期待値は3つの方法で届く。
人間が設定する場合:リクエストをコレクションで定義し、期待するレスポンスをアサーションとして記述し、ツールが実際の値をその設定と照合する。仕様が宣言する場合:OpenAPIドキュメントが各エンドポイントの返り値を定義し、その宣言からテストが生成される。あるいはAIが推測する場合:モデルがハンドラーコードを読み込み、レスポンスに含まれるべき内容についてもっともらしいアサーションを生成する。
この3つはすべて共通の構造を持つ。期待値はコールが行われる前から存在し、APIそのものではなくAPIの説明から導かれる。ツールの役割は、実際の値をその事前の説明と比較することだ。
この構造は説明が正確かつ最新である場合に機能する。そうでない場合は特定の予測可能な形で劣化する。AIが生成するバックエンドではこれが頻繁に起きる。シリアライザーはハンドラーが言及しないフィールド名を変更し、リファクタリングは4箇所中3箇所しかコードを更新せず、実行中のAPIはソースコードを含むあらゆる説明から乖離していく。
エビデンスに基づくとはどういう意味か
エビデンスに基づくエージェントは順序を逆転させる。まず観察し、次に期待値を定める。
TestSpriteのBackend Testing 2.0はこの方式で構築されている。アサーションを生成する前に、エージェントはエンドポイントを呼び出して実際のレスポンスを記録する。実際のフィールド名、実際のステータスコード、実際の形式だ。その後のアサーションは、設定・宣言・推測された内容ではなく、観察された内容を記述する。
他の検証ツールはコードを読んで推測します。TestSpriteはあなたのアプリを開いて実際に使います。
エビデンスはテストの構成要素を変える。動的な変数は実際のレスポンスから生成される。createコールが返した実際のIDが、文書化された約束ではなく実証されたデータから組み立てられるマルチステップチェーンを通じて受け渡される。観察されたコントラクトがリグレッションのベースラインとなるため、後の変更は2つの観察の比較として浮かび上がる。以前このエンドポイントが返した値、現在返している値、変更されたフィールド。そして存在しないフィールドを参照するチェーンは構築できない。すべての参照が記録されたレスポンスに紐づくためだ。
連鎖する影響:3つの実践的な違い
初回実行時の信頼性。与えられた期待値がテスト実行時に初めて実際の値と対面すると、誤ったケーシング・誤ったステータス・誤ったネスト構造といった不一致が、テストに関するデバッグ作業を生む。観察された期待値はすでに実際の値と対面済みであるため、初回実行では製品に関する指摘が生まれる。
APIが進化したときのメンテナンス。与えられた期待値は再提供が必要だ。誰かがコレクションを更新し、新しい仕様から再生成し、新しいコードから再推測する。観察された期待値は観察によって更新される。ベースラインが実際の値から更新され、真の逸脱は警告されるが、暗黙のうちに吸収されたり誤検知を起こしたりしない。
障害発生時の診断。与えられた期待値による失敗は、アサーションが一致しなかったことを示すにとどまり、エンジニアが実際の値と説明のどちらが間違っているかを判断しなければならない。エビデンスに基づく失敗はその判断そのものだ。エンドポイントは以前Xを返していたが今はYを返しており、下流で旧形式を読み込んでいる箇所はここだ。
従来ツールが依然として適している場面
与えられた期待値モデルが廃れたわけではない。期待値自体がコントラクトである場合——顧客への約束として文書化された仕様を持つ公開API——では、宣言に対してテストすることに意味がある。実際の値が約束から乖離したときに把握したいのであり、仕様が権威となる。インタラクティブな開発においても従来ツールが有利だ。手動でリクエストを作成してレスポンスを検査することは、探索であってリグレッションではない。
エビデンスに基づくモデルが適しているのは、実行中のシステムが権威となるあらゆる場面だ。内部API、高速に変化するバックエンド、AIが生成するサービスにおいては、ほぼ常にそれが当てはまる。
シナリオ:ロイヤルティAPI、2つのアプローチ
あるチームがClaude Codeでロイヤルティポイントを管理するAPIを構築した。購入でポイントを獲得し、チェックアウト時に使用し、残高を確認する機能だ。あるセッションで換金エンドポイントが最適化される。
与えられた期待値のアプローチでは、コレクションが換金レスポンスにremainingPointsという整数フィールドが含まれることをアサートする——これまでそうだったからだ。最適化によりレスポンスのバランス情報がbalanceオブジェクト配下にネストされ、{ balance: { points: 4200, tier: "gold" } }という形式になった。そのためアサーションが失敗し、エンジニアはその日の午前中を費やして、APIは問題なく変更は意図的なものであり、コレクションのほか古いフィールドを参照する4つのリクエストも更新が必要だと確認するハメになる。
エビデンスに基づくアプローチでは、同じ変更がコントラクトの逸脱として完全なコンテキストとともに浮かび上がる。換金APIはremainingPointsをトップレベルで返していたが、現在はbalance.pointsを返しており、チェックアウトフローの残高表示が古いパスを参照している。この最後の一節こそが重要な指摘だ。同じ実行でフロントエンドを探索していたエージェントが、チェックアウトページの残高が表示されるべき箇所に空白があることを確認する。1つのレポートに原因と結果が紐づいて、修正に数分しかかからないClaude Codeのターミナルへ届く。
同じ変更、同じ午前中。一方のモデルはメンテナンス作業を生み、もう一方は診断を生んだ。
まとめ
APIテストツールは、設定・仕様・推測によって与えられた期待値を実行する。エビデンスに基づくバックエンドテストエージェントは、観察によって期待値を形成する。まず呼び出し、実際の値を記録し、見たものに対して検証し、リグレッションを2つの観察の比較として扱う。
起源の違いは、下流のあらゆる面での違いに変わる。テストのデバッグではなく製品の指摘を生む初回実行、再説明ではなく観察によって行われるメンテナンス、そして不一致ではなく診断として届く障害。AIコーディングの速度で変化するバックエンドにとって、エビデンスこそが定義上常に最新の状態を保つ唯一の記述だ。
今すぐTestSpriteで、エビデンスに基づいたAPIテストを始めよう。無料プラン、クレジットカード不要。