既存のコードベースからテストを生成する方法
 Zeshi Du
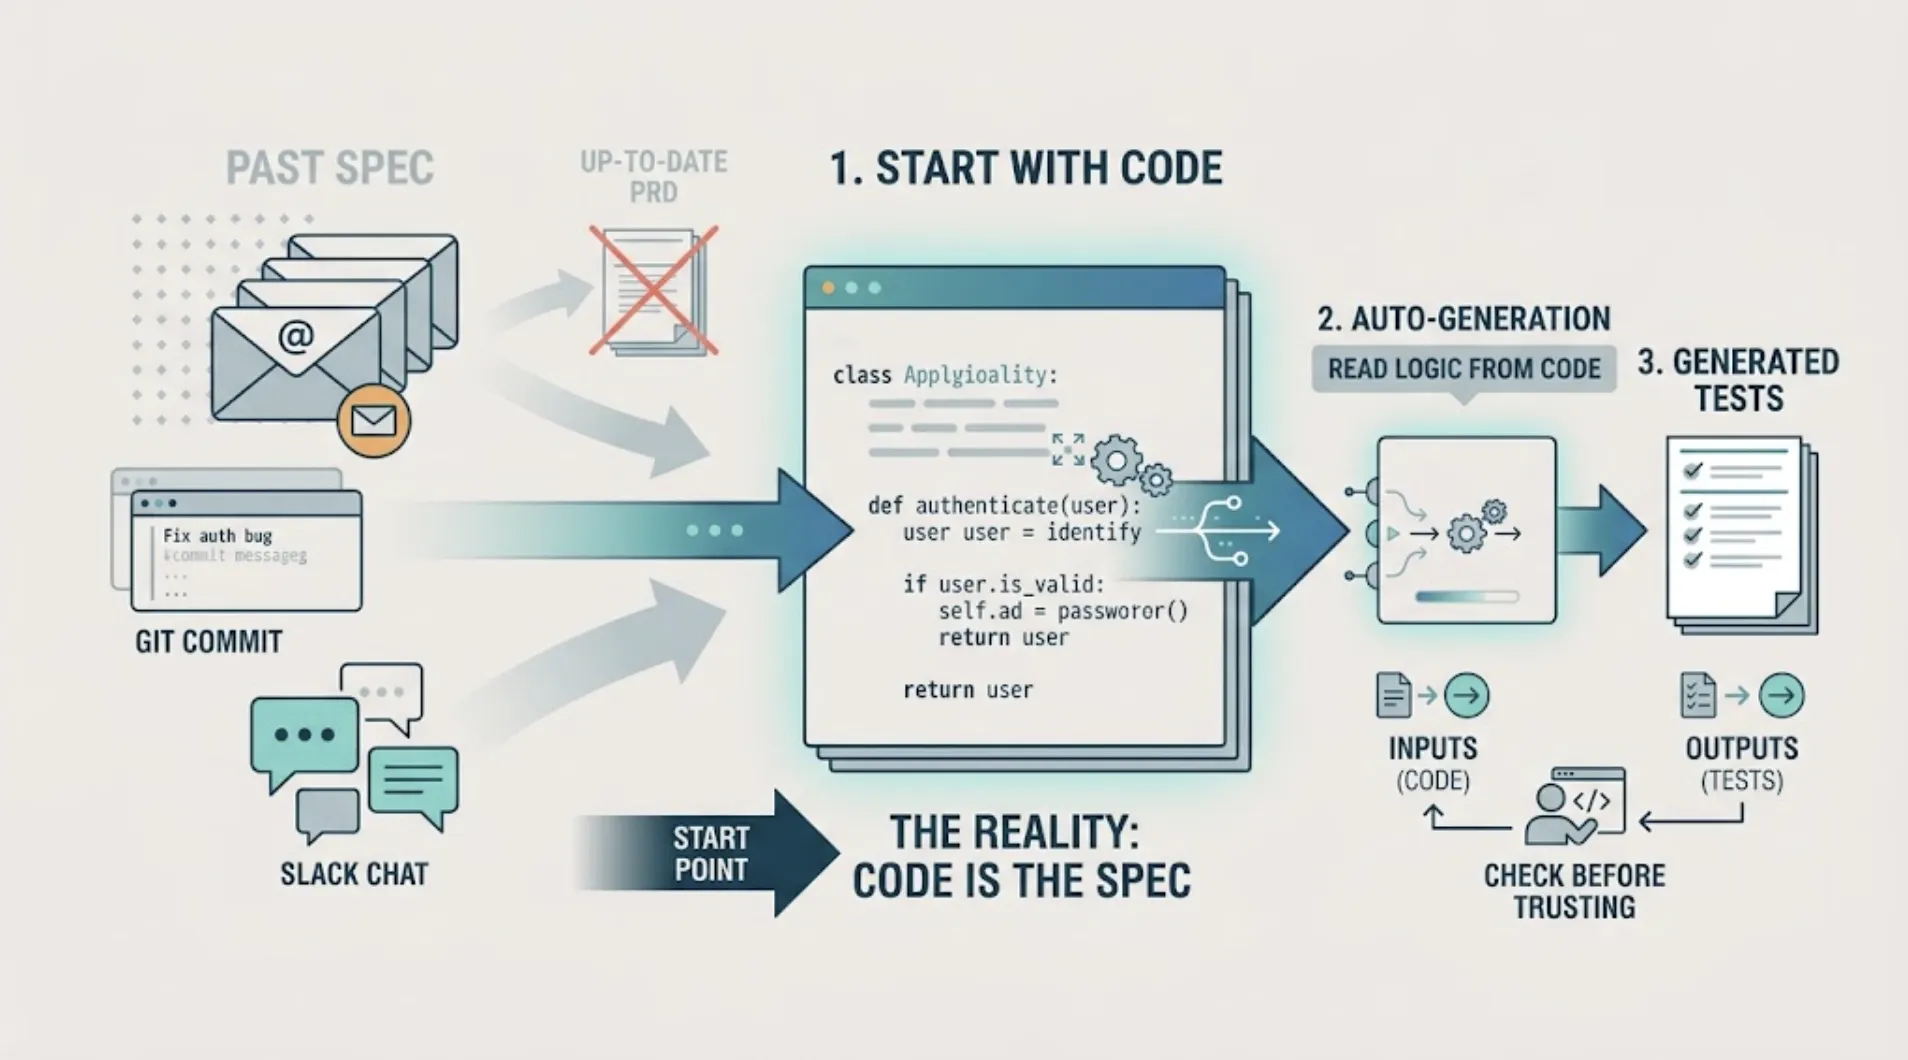
ほとんどの実際のプロジェクトには、最初からPRDが存在しなかったとしても、最新の状態に保たれたPRDはありません。仕様はコミットメッセージ、Slackのスレッド、そして創業者の記憶の中に存在しています。
だからといって、AIテストケースジェネレーターが選択肢から外れるわけではありません。出発点がドキュメントからコード自体に移るということです。その仕組みと、生成されたものを信頼する前に確認すべきことを説明します。
コードのみによるテスト生成が異なる問題である理由
書かれたPRDが存在する場合、エージェントはプロダクトが明示的に何をすべきかにテスト目標を紐付けられます。PRDがない場合、利用可能なシグナルはコードが現在行っていることだけです。これは特定のリスクをもたらします。実装にバグがある場合、その実装だけから生成されたテストは、照合すべき独立した意図の宣言がないため、そのバグを正しい動作としてひっそりとエンコードしてしまう可能性があります。
優れたコードベース推論は、現在の実装を単に説明するだけではありません。意図を推測する必要があります。コードが行ごとに何をしているかではなく、何を実現しようとしているかです。この違いこそが、本当に有用な推論されたPRDと、既存のバグをそのまま反映するだけのテストスイートを分けるものであり、TestSpriteのMCP Serverが取り組む具体的な問題です。
TestSpriteがPRDなしで意図を推測する方法
IDEのMCP Serverを通じて、TestSpriteはプロジェクト構造、ルート定義、コンポーネント階層、およびAPIコントラクトを分析し、その分析から正規化された内部PRDを構築します。存在するものを説明するためにコードを読んでいるのではなく、何を実現するために構築されたかを再構築するためにコードを読んでいます。
“他の検証ツールはコードを読んで推測します。TestSpriteはあなたのアプリを開いて実際に使います。”
ここではその後半部分も前半と同様に重要です。静的なコード分析だけでは、製品が実際に動作したときにのみ現れるフロー(ユーザーロールによってゲートされた機能、特定のアクションの後にのみ表示されるマルチステップウィザードなど)を見落とす可能性があります。コードベース推論と実際に動作しているアプリのライブ探索を組み合わせることで、そういったものを捉えることができます。
実践的なプロセス
エージェントをコードベースと動作中のアプリケーションの両方に向けてください。どちらか一方だけではありません。MCP Serverを通じた新しいプロジェクトのセットアップは、静的な構造と、アプリを実際にナビゲートすることで探索エージェントが発見する内容を組み合わせた分析から始まります。
生成されたカバレッジを信頼する前に、推論されたPRDをレビューしてください。これは、チェックするための要件ドキュメントが存在しない場合に最も重要なステップです。TestSpriteがあなたの製品が何をすべきと結論付けたかを読み通し、誤った内容があれば、それが何十もの生成されたテストの根拠になる前に修正してください。
信頼性の要因としてコードベースの明確さを確認してください。明確な命名、一貫したパターン、可視性の高い構造を持つコードベースは、有機的に成長し内部の一貫性がほとんどないものよりも、推論エンジンにとってより多くの手がかりを提供します。これは、雑然としたプロジェクトでコードベースベースの生成を避ける理由ではありません。最初のレビューパスがより重要になることを意味しています。
静的分析だけでは見落とすものを探索で捉えてください。並列探索エージェントは、実際のユーザーと同じようにライブアプリケーションをナビゲートし、発見した内容の構造化されたマップを報告します。この探索の進行を見ること自体も有用な健全性チェックになります。エージェントが重要なフローを見落とした場合、生成されたカバレッジを信頼する前にそれに対処する価値があります。
書かれたPRDがまだ書く価値がある場合
コードベース推論は、意図のドキュメント化の永続的な代替手段ではなく、真に有能なフォールバックです。プロジェクトが複数人が作業するまで成熟した場合、または機能の正しい動作がコードだけでは明確でない場合(誰かの頭の中にしか存在しないエッジケースを持つビジネスルールなど)、その時点で短いPRDを書くだけでも、TestSpriteが生成するものの精度が著しく向上します。PRDが用意できれば、そのPRDから新機能のカバレッジを追加するのも同じワークフローで、より明確な出発点から始められます。
推論されたPRDが実際に正確かどうかを確認する方法
コードのみのプロジェクトで生成されたカバレッジを信頼する前に、推論が正しいと仮定せず、数分かけて推論されたPRDと製品が何をすべきかについての自分の知識を比較する価値があります。特に2つの失敗パターンに注目してください。意図ではなく現在の実装で説明されている機能(推論がコード構造に頼りすぎて探索が不足しているサイン)、および誰もエージェントが見つけられる場所に書き残していなかったビジネスルールによってのみ存在する欠落したエッジケース。
どちらの失敗パターンも、アプローチが機能しないことを意味しません。どちらも、誤ったことを静かに検証するテストスイートの根拠になる前に、迅速な人間によるレビューが早期に発見できる正確なギャップです。コードベースの一貫性と可読性が高く、探索エージェントがライブアプリケーションを十分に検索できるほど、最初からこのギャップは小さくなります。
特に古いコードベースで行う価値のある関連チェックがあります。明らかに構築されたが、古いコードが削除されることなく部分的に放棄または置き換えられた機能を探してください。推論では、ルートやコンポーネントがアクティブな機能ではなく不要なコードかどうかを知る方法がないため、推論されたPRDに記載されている内容で実際には誰も使用していないとわかっているものをフラグ立てする価値があります。これは、生成されたテストが誰も実際に保存する必要のない動作を検証し始める前に行うべきです。レビューパスでの短いメモがあれば、通常は不要なコードを生成されたスイートから除外するのに十分です。
まとめ
既存のコードベースからPRDなしでテストを生成することは、妥協案ではなく、実用的かつ現実的なアプローチです。ただし、レビュー時の注意点が変わります。すでに信頼できるドキュメントと照合して生成されたテストを確認するのではなく、TestSpriteが推測した意図が実際に意図したものと一致しているかどうかを、その推測が下流のすべての基盤となる前に確認する必要があります。
TestSpriteのMCPサーバーは、PRDが存在しない場合でもコードベースから直接この推測を行います。開始するために別途ドキュメント作成のステップは不要です。ご自身のプロジェクトで無料でお試しいただき、何が推測されるかをご確認ください。推測されたPRDとご自身のプロダクト理解を比較することで、このアプローチがうまく機能するほどコードベースが明確かどうか、あるいは簡潔な文書化されたPRDが結果を改善するかどうかを最も素早く判断できます。