リリース前にバックエンド統合バグを発見する方法
 Rui Li
最もコストの高いバグは、単一サービス内のものではありません。それぞれ単体では正常に見える 2 つのサービスの間のスペースに潜むものです。つまり、バグ追跡ツールが気づく頃には実際のユーザーがすでに問題に直面した後であり、修正コストが本来より高くなっています。
そのカテゴリのバグをリリース後ではなく、リリース前に発見する方法を紹介します。
各サービスが自身のテストを通過するだけでは不十分な理由
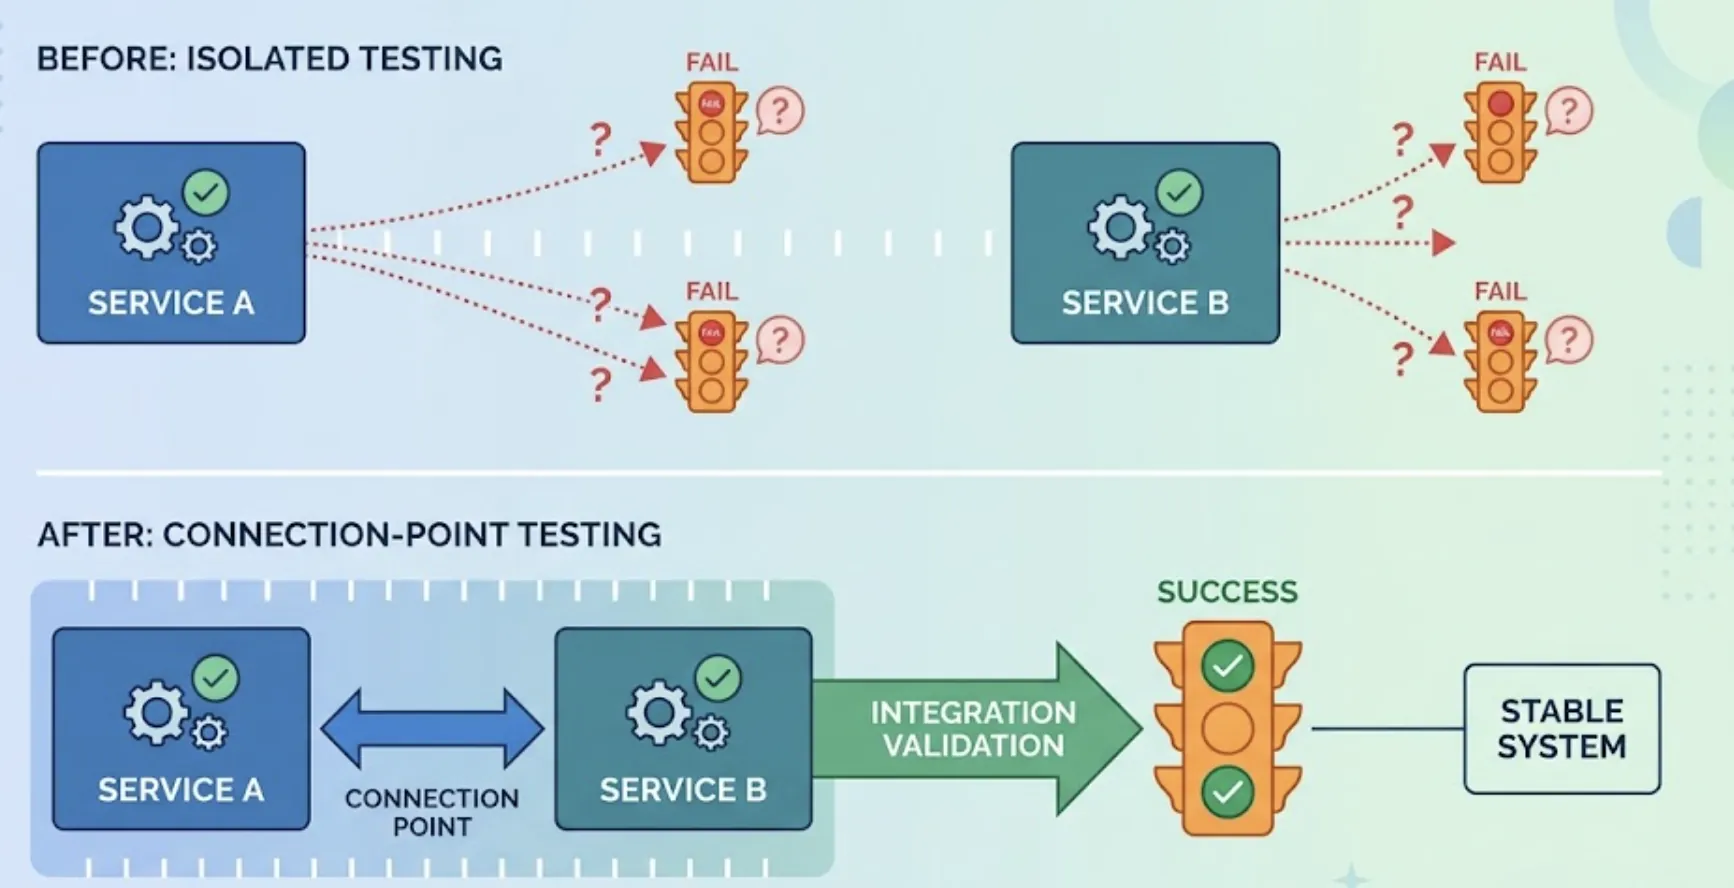
サービス A のテストスイートはサービス A の動作を確認します。サービス B のテストスイートはサービス B の動作を確認します。しかし、サービス A の現在の出力がサービス B の現在の期待と実際に互換性があるかを確認するスイートはありません。どちらのスイートも、相手サービスの現在の動作を念頭に置いて書かれておらず、どちらのチームも相手のテストがどのように構成されているかを把握していないからです。これが TestSprite の Backend Testing 2.0 が解消するために設計された具体的なギャップです。
TestSprite がクロスサービスのドリフトを検出する方法
“他の検証ツールはコードを読んで推測します。TestSpriteはあなたのアプリを開いて実際に使います。”
各サービス固有の内部テストを信頼するのではなく、TestSprite は一つのサービスから実際のレスポンスを観察し、エンドポイントをまたぐマルチステップシーケンスをチェーンする統合テストを使用して、次のサービスの実際のバリデーションに通します。MCP Server を通じて、これは各サービスを個別にカバーするテストパスの一部として実行されるため、クロスサービスのドリフトは別途統合テストを行う必要なく、同じレポートに表示されます。
注意すべき具体的なパターン
特に注意すべき一般的な障害パターンがあります。サービス A がレスポンスにオプションのフィールドを追加し、必要がなければコンシューマーは無視することを期待します。しかし数か月前に作られたサービス B は、予期しないフィールドを含むレスポンスを拒否する厳格なスキーマバリデーションを持っています。どちらのチームも自分たちの視点からは何も間違ったことをしていません。変更後に統合が再検証されなかっただけです。その境界を具体的に担当するオーナーが誰もいないからです。
関連するバリアントは形状ではなくタイミングに関するものです。サービス A が以前は同期的だった処理を変更後に非同期で結果を返すようになり、即時レスポンスを前提にしていたサービス B が、実際に結果がシステムに存在する前に処理を進めてしまいます。両サービスは独立して正常に動作しています。破られた前提はどちらのチームも確認できる場所に書き留められておらず、自分たちのサービスには何も問題がないように見えたため、誰も相手側を更新しようとは思いませんでした。
各サービス固有の内部テストを信頼するのではなく、サービス A の実際の現在のレスポンスを観察してサービス B の実際の現在のバリデーションに通すテストこそが、この特定のドリフトのクラスを確実に捉えます。
発見した後にすべきこと
統合バグがリリース後ではなくリリース前に発覚した場合、修正は通常はるかに安価です。実際のユーザーデータがすでに影響を受けた状態でのインシデント対応やロールバックではなく、スキーマバージョンのバンプ、2 つのチーム間で明確に伝達された明示的なコントラクト変更、または小さなバリデーションの調整で済みます。早期発見の価値は、バグ自体を回避することだけではありません。インシデント対応中ではなく、通常の作業時間に計画的な修正として対処できるかどうかの違いです。
これを一度限りのチェックではなく、定期的な習慣にする
クロスサービスのドリフトは、一度発生して終わるものではありません。サービスはそれぞれ独立して進化し続けるため、リリース間で統合リスクが静かに蓄積されていきます。定期的な再検証がなければ、誰もその蓄積に気づかず、最終的にダウンストリームのどこかで症状が現れて初めて問題が発覚します。Monitoringを通じてこれらのチェックをスケジュールしておけば、次のデプロイ前に誰かが手動で実行することを覚えておくことに依存せず、再検証が自動的に行われます。
どのサービス境界を優先的に対処すべきか
すべてのサービスペアが同じ統合リスクを抱えているわけではありません。優先すべき境界は、一方の変更がもう一方を担当するチームに最も気づかれにくいものです。具体的には、異なる担当者やチームが所有するサービス、デプロイ頻度が低くドリフトを忘れやすいサービス、そして境界を越えるデータが課金・権限・ユーザーがすぐに誤りに気づくような領域に直接影響するサービスが該当します。
小規模チームにとって有効な方法は、互いに呼び合うすべてのサービスペアをリストアップし、誰かが意図的にその境界を再検証してから経過した時間順にランク付けすることです。リストの上位にあるペア、つまり数ヶ月間誰もチェックしていないもの、は次の問題が発生しやすい場所です。活発な開発の副産物として毎週触れられているものではなく。オーナーシップやデプロイ頻度が変化するにつれて優先順位が正確に保たれるよう、このリストを一度きりで忘れるのではなく四半期ごとに見直すことで、本番インシデントを一件追跡するよりもはるかに少ない時間で済みます。
まとめ
統合バグは、それぞれ単独では正常に見えるサービスの間の空間に潜んでいます。リリース前にそれらを検出するには、境界の両側で実際の動作を観測し、個々のパーツをそれぞれ独立してテストするのではなく、クロスサービスのシーケンス全体をテストし、サービスが互いに独立して進化し続けるにつれてスケジュールに従って再検証することが必要です。
TestSpriteのBackend Testing 2.0は、このカテゴリのバグがプロダクションに到達する前に、製品が実際に持つすべてのサービス境界をまたいで検出するために特別に設計されています。ご自身のサービスで無料でお試しいただき、どのようなドリフトが検出されるか確認してください。最も安定しているように見えるサービスが、実は最も長い間再チェックされていないものであることが多く、どの2つのサービスがひっそりと乖離していたかに、ほとんどのチームが驚きます。
このカテゴリが過小評価されやすい理由
単一サービスのバグは通常、明確かつ迅速に自己申告します。エンドポイントが500を返す、ページがクラッシュする、コードベースのある明らかな箇所に紐づいたエラーがログに表示されるといった具合です。クロスサービスの統合バグはより静かです。両方のサービスが正常を報告します。両方が独自のテストに合格します。障害はダウンストリームの症状としてのみ現れます。作成されないレコード、送信されない通知——そして、その症状を実際に壊れた境界まで遡るのに、発見後の修正よりもはるかに長い時間がかかることがあります。発見後は修正が容易だが追跡にコストがかかるというこの非対称性こそ、他のほとんどのバグカテゴリよりも、リリース前に検出することが重要である理由です。