スケジュール済みリグレッションテストは、既知のフレーキーな失敗からどのように自動的に回復できるのか?
 Zeshi Du
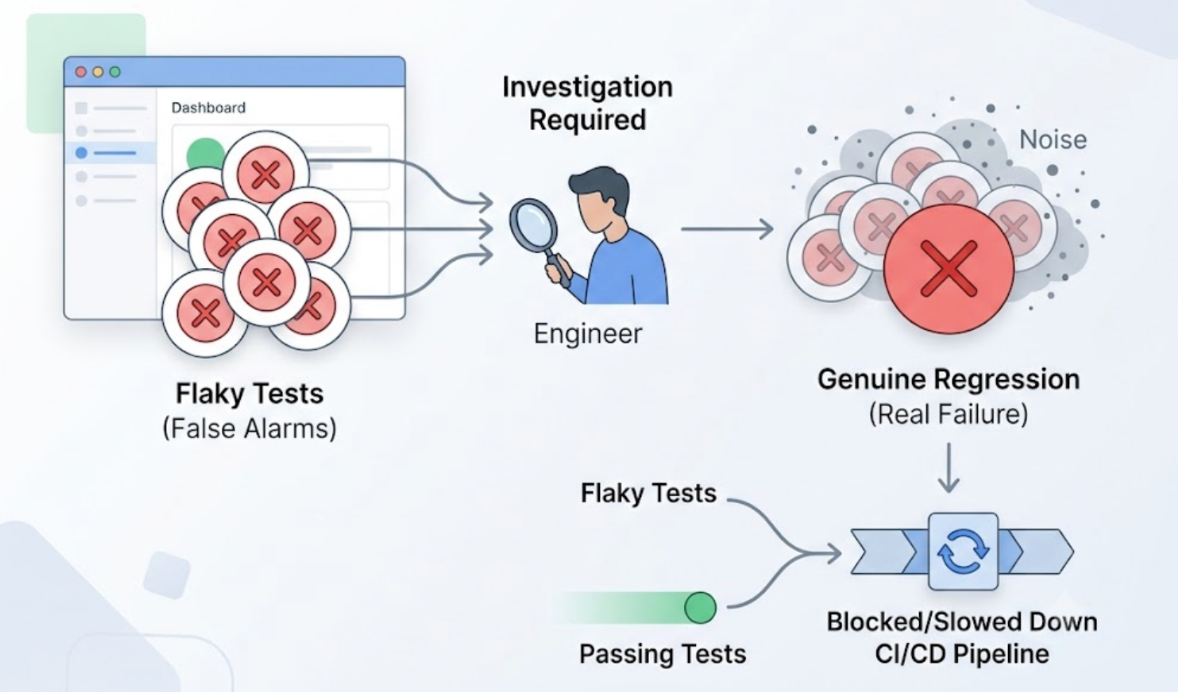
スケジュール済みテストスイートを持つすべてのチームが知っている感覚があります。夜間実行が終わります。朝のダッシュボードが赤くなっています。エンジニアが調査すると、トークンの有効期限切れ、UI要素の移動、またはネットワーク呼び出しがわずかに時間超過するたびに必ず失敗する、あの3つのテストがまた失敗していることが分かります。
これらは本当の失敗ではありません。誰もがそれを知っています。しかし、スイートがそれらを本当の失敗と区別できないため、いずれにせよ調査しなければなりません。無視した唯一の機会が、本物のリグレッションがノイズの下に埋もれていた機会になる可能性があるからです。
スケジュール済みリグレッションにおけるフレーキーな失敗は、些細な不便ではありません。チームのスイートへの信頼を損ない、チームが処理できる速度よりも速くノイズを生成するテストスイートは、最終的に完全に無視されるようになります。そうなると、スイートはカバレッジの外観を提供するものの、実態を伴わないものになってしまいます。
サイレントリカバリーが答えです。既知のフレーキーな失敗カテゴリーを自動的に処理し、本物のリグレッションのみを表面化させ、毎朝エンジニアがその判断を行う必要のないメカニズムです。
失敗が本当にフレーキーである条件とは
フレーキーな失敗にはいくつかの明確なカテゴリがあり、リカバリーの仕組みを理解するにはこれらを把握することが不可欠です。
UIのドリフト。コンポーネントの名称が変更され、要素が移動し、レイアウトがずれる。テストは古い構造に対して書かれていた。プロダクトは想定通りに動作している。しかし、テストは動作上の結果ではなく実装の詳細に依存していたため、失敗する。
認証情報の期限切れ。スケジュールされたテストが午前3時に実行される。それ以前に発行されたOAuthトークンが期限切れになる。認証ステップが失敗するのは、プロダクトの認証フローに問題があるからではなく、テスト環境の認証情報が古くなったためだ。
依存サービスの利用不可。テストが依存するサードパーティAPIが夜間の実行中に短時間ダウンした。テストは失敗した。プロダクトは問題なかった。
初回実行時の初期化。新たに生成されたテストが初めてフローを実行する。フロー自体は正常に動作しているが、テストの前提条件に合う初期状態の設定が不完全だった。テストは初回の試みで失敗し、2回目では成功するだろう。
本物の失敗は異なる様相を示します。昨日は正常だったプロダクトの動作が、今日は誤っている。これは調査する価値があります。それ以外のケースは、自動的に対処する価値があります。
サイレントリカバリーが求めるもの
サイレントリカバリーとは、失敗を無視することではありません。失敗が発生した時点で正確に分類し、分類可能なものは自動的に処理し、本当に不明なケースだけを人間のレビューに回すことです。
これには、経験豊富なQAエンジニアが夜間の失敗を見たときに行うことをテストシステムが実行する必要があります。つまり、「プロダクトが壊れた」「テストが適応する必要がある」「環境に一時的な問題があった」を区別することです。
ほとんどのテストツールはこの区別ができません。動作上の結果と実装の詳細の違いを認識していないからです。コードの構造に基づいてテストを生成するため、コード構造に変化があれば何でも失敗として認識してしまいます。
関数が返す値ではなくユーザーが体験することを検証するプロダクト層で動作するテストエージェントは、この分類をより明確な基盤の上で行うことができます。
TestSpriteがスケジュール済みリグレッションにおけるフレーキーな失敗を処理する方法
TestSpriteは、スケジュール済みリグレッションにおけるフレーキーな失敗を、最も一般的なカテゴリを自動的に処理する2つのメカニズムで解決します。
Auto-Heal RerunはUIのドリフトを処理します。スケジュール済みリグレッションテストが失敗した際、TestSpriteはその失敗が本物の動作上のリグレッションなのか、ユーザー体験に影響しないUI構造の変化なのかを判断します。同じ動作をする名前変更されたボタン。ユーザーが引き続き操作できる位置変更されたフォームフィールド。同じコンテンツを異なる形で表示するスタイル変更されたレイアウト。
失敗が構造的なものである場合、テストは適応します。誤った失敗を報告しません。エンジニアがセレクターを更新する必要もありません。スイートは正常に実行され続け、朝のダッシュボードには対処すべき失敗のみが表示されます。
これが可能なのは、TestSpriteがプロダクト層でテストを行うからです。他の検証ツールはコードを読んで推測します。TestSpriteはアプリを開いて実際に使用します。
エージェントがUIフローを実際のユーザーのようにナビゲートして操作する場合、特定のCSSクラス名や特定の要素の位置に縛られません。フォームを送信するボタン、メールアドレスを受け付けるフィールド、確認メッセージを表示するコンポーネントを探しています。それらが期待通りの機能的な位置に存在すれば、テストは合格します。存在しなければ、正当な理由でテストは失敗します。
Auto-Authは認証情報の期限切れを処理します。パスワードエンドポイント、OAuthリフレッシュトークン、AWS Cognitoのフローは、スケジュール済みのテスト実行ごとに自動的に実行されます。エージェントは毎回、新しい認証情報を使用した実際のログインフローを通じて認証済みの状態に到達します。午前3時のスケジュール実行が、前日の午後に発行されたJWTの期限切れで失敗することはありません。
依存サービスが利用不可だったり、必要な値が欠落していてテストが実行できない場合、TestSpriteは誤解を招く赤色の失敗ではなく、わかりやすい英語の説明とともにBlockedステータスを表示します。朝の結果を確認するエンジニアは、その問題が調査に値するものか、環境に一時的な障害があっただけなのかを即座に把握できます。
シナリオ:ノイズを出力しなくなったスイート
あるチームがSaaSプロダクトで毎晩リグレッションテストを実行しています。TestSpriteを設定する前、スケジュール済みスイートは1回の夜間実行で平均4〜6件の失敗を出力していました。2〜3件は常に同じトークン期限切れの失敗でした。1〜2件は前日のフロントエンド作業後のUI構造の失敗が典型的でした。残りの1〜2件が調査する価値のある本物のリグレッションでした。
問題は、本物の失敗を見つけるためにすべてを調査しなければならなかったことです。それによって、毎朝本来の業務を開始できるまでに30〜90分かかっていました。
スケジュール済みリグレッションにTestSpriteに切り替えた後:
Auto-Authによってトークン期限切れの失敗が完全になくなりました。スイートは実行のたびに新しい認証情報で認証済みの状態に到達するようになりました。
Auto-Healによってフロントエンドの変更後のUI構造の失敗がなくなりました。プロダクトチームがいくつかのダッシュボードコンポーネントを再設計した際も、スイートは手動更新なしに適応しました。コンポーネントは引き続き正常に機能しており、テストはそれを認識しました。
Blockedステータスにより、夜間の実行中にサードパーティの分析サービスが利用できなかった2回の事例が正確に識別されました。それらはプロダクトの失敗ではなく、調査なしに処理されました。
朝のダッシュボードに残ったのは本物のリグレッションのみでした。最初の1か月間に2回、スイートはユーザーに届いていたかもしれない本物の動作上の変化を特定しました。どちらも次の営業日前に発見・修正されました。
朝の調査時間は平均45分から10分未満に短縮されました。スイートは、チームが検証しなければならないものではなく、信頼できるものになりました。
これを支えるスマートなスケジュール機能
リカバリーメカニズムに加え、TestSpriteのスケジュール済みリグレッション実行には、人間のレビューが必要な場合に結果を把握しやすくするレポート機能が含まれています。
「前回との変更点」列により、前回の実行と現在の実行の間でどのテストが状態を変えたかが一目でわかります。2週間合格し続けていたテストが突然失敗した場合、断続的にフレーキーだったテストとは明確に区別されて即座に確認できます。
失敗メールには、失敗したテストごとの原因についてAIが作成した説明がインラインで含まれています。夜間の結果を確認するエンジニアは、何が壊れたかを理解するためにダッシュボードにログインする必要がありません。説明が手元に届きます。
GitHub Actionsインテグレーションを使用しているチームでは、プルリクエストのCI実行にも同じリカバリーメカニズムが適用されます。PRにおけるUI構造の変更が、本物の失敗を覆い隠す大量の誤った失敗を引き起こすことはありません。
まとめ
スケジュール済みリグレッションテストは、テストシステムが「プロダクトが壊れた」「テストが適応する必要がある」「環境に一時的な問題があった」を区別できる場合に、既知のフレーキーな失敗からサイレントにリカバリーします。
TestSpriteのAuto-Healは、コード層ではなくプロダクト層でテストすることでUIのドリフトを処理します。Auto-Authは、実行のたびに認証をリフレッシュすることで認証情報の期限切れによる失敗をなくします。Blockedステータスは、環境の依存関係の問題をプロダクトの失敗として誤ったラベルを付けることなく正確に分類します。
朝のダッシュボードには調査する価値のあるものが表示されます。それ以外は自動的に処理されます。
調査のオーバーヘッドが生産的な時間を圧迫しており、テストスイートにノイズが蓄積して信頼性が失われているチームにとって、これこそがスケジュール済みリグレッションスイートが本来果たすべき役割の回復です。
TestSpriteでスケジュール済みリグレッションを設定し、調査する価値のない失敗の調査をやめましょう。