AIエージェントを使って自然言語でプロジェクトをテストできますか?
 Zeshi Du
はい。一文で十分です。
「TestSpriteでこのプロジェクトをテストしてください。」
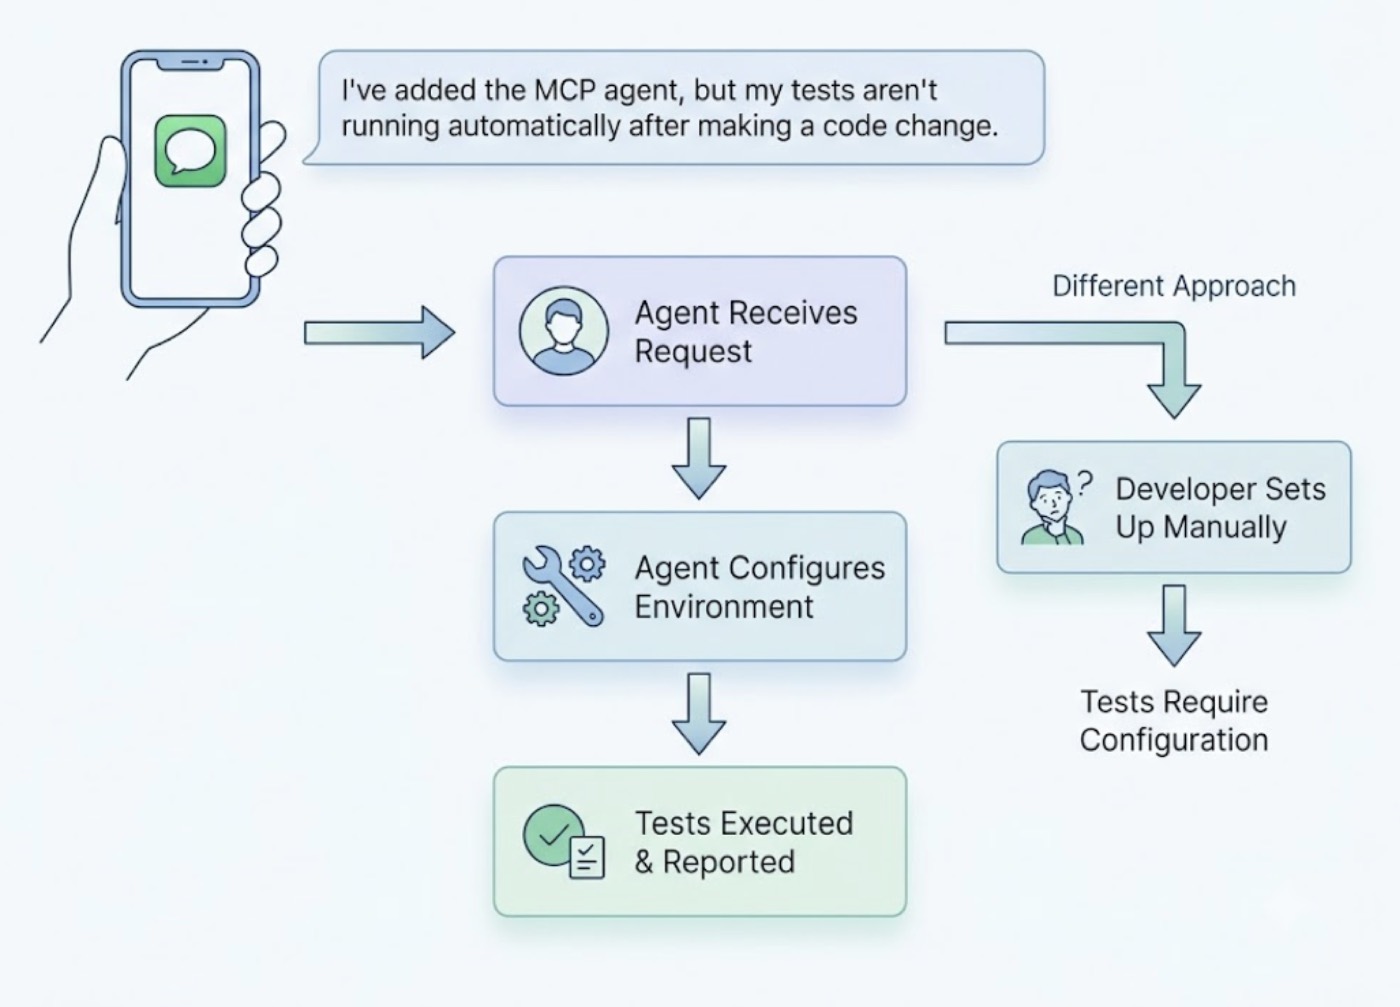
Claude Code、Cursor、Windsurf、またはMCP対応のAI IDEのチャットインターフェースにそのひと言を入力するだけで、完全に自律的なテストパイプラインが起動します。開発者はテストランナーを設定したり、テストファイルを書いたり、カバーするフローを指定したりする必要はありません。エージェントがそこから引き継ぎます。
より興味深い問いは、それが可能かどうかではありません。その一文を入力した後に実際に何が起こるか、そしてなぜそれが自然言語入力を受け付ける他のツールと根本的に異なるものを生み出すのか、という点です。
自然言語の入力が有用な結果を保証するわけではない
多くのテストツールが自然言語を受け付けます。テスト対象の説明を受け取り、それをテストコードに変換し、ソースファイルに対してそのコードを実行します。インターフェースは会話形式ですが、検証はコードレイヤーで行われます。
この限界はすぐに現れます。開発者が「チェックアウトフローをテストして」と入力すると、ツールはチェックアウトコンポーネントを読み込み、関連する関数を特定し、各関数が期待値を返すことを検証するアサーションを生成します。テストはパスします。しかし、実際のユーザーが特定の入力の組み合わせを行い、送信前に戻るナビゲーションをしたときにのみ現れるバグがチェックアウトフローに存在します。そのバグは本番環境に届きます。
自然言語インターフェースによってツールは使いやすくなりました。しかし、ツールが検証する内容は変わりませんでした。
自然言語テストから有用な結果を得るには、指示をコードのアサーションに変換するエージェントではなく、指示を受け取って実際にその操作を行うエージェントが必要です。
「このプロジェクトのテストを手伝って」が実際にトリガーするもの
TestSpriteのMCPサーバーを通じてその指示が届いたとき、レスポンスはテストファイルではありません。テストセッションです。
他の検証ツールはコードを読んで推測します。TestSpriteはあなたのアプリを開いて実際に使います。
並列探索エージェントの集団が実際に動作しているアプリケーションを訪問し、実際のユーザーと同じようにナビゲートします。何をテストすべきかを判断するためにソースファイルを読み込むのではありません。ライブプロダクトにアクセスし、インタラクションを通じてそのプロダクトが何をするかを発見し、そのインタラクションから実際のユーザージャーニーの構造化されたマップを構築します。
ボタンをクリックします。プレースホルダー値ではなく実際の入力値でフォームを入力します。入口から完了まで複数ステップのフローを移動します。ハッピーパスのユーザーが辿るルートも、困惑したユーザーや好奇心旺盛なユーザーが辿るルートも試みます。実際のブラウザセッションと同じようにステップをまたいでセッション状態を引き継ぎます。
PRDが存在する場合、TestSpriteはそれを解析してプロダクトが実現すべきことに探索をアンカリングします。存在しない場合、MCPサーバーはルート定義、APIコントラクト、コンポーネント構造を設計意図の根拠として使用し、コードベース自体からプロダクトの意図をリバースエンジニアリングします。エージェントは現在の実装ではなく、その意図モデルに対してプロダクトを探索します。
シナリオ:一文、一セッション、一つのバグ発見
開発者がCursorを使ってSaaSアプリケーションの設定ページのリファクタリングを完了しました。AIはフォームレイアウトを再整理し、バリデーションロジックを整理し、プリファレンスの保存方法を更新しました。差分では問題ないように見えます。
プッシュ前に、開発者はCursorのチャットに一文を入力します:
「TestSpriteでこのプロジェクトをテストしてください。」
探索エージェントは設定ページにナビゲートし、実際のユーザーと同じようにページを操作し始めます。アカウント名を入力し、メールアドレスを更新し、通知設定を変更して保存します。
最初の実行で、フォームの保存は期待通りの成功メッセージをトリガーするものの、ページを更新すると更新されたメールアドレスが保持されないことを発見します。保存ハンドラーは他のプリファレンスを正しく書き込みますが、リファクタリングされたコードのバリデーションチェックが書き込み関数に到達する前にその値を破棄しているため、メールアドレスの更新が静かに無視されていました。
コードはエラーを起こしません。UIは成功を表示します。保存後にプロフィールを確認するユーザーだけが気づきます。保存関数が実行されて成功メッセージが表示されるため、コードレイヤーのテストはパスしていたでしょう。
障害はCursorのチャットに構造化された形式で返されます:更新されたフィールド、期待される永続化された値、更新後のページに表示された内容。コーディングエージェントはその説明を使用して破棄されているバリデーションを特定し、同じセッション内で修正を提案します。開発者はレビューして適用し、修正が機能することを確認するために再度その指示を入力します。
たった一文で、全サイクルが動き出した。
自然言語からバックエンドカバレッジへ
自然言語の指示がカバーする範囲は、画面上に見えるものだけではありません。APIレイヤーも対象です。
TestSpriteのバックエンドテスト2.0は、同じ「まず観察する」アプローチをAPIにも適用します。バックエンドのテスト計画を生成する前に、エージェントはエンドポイントを実際に呼び出し、実際のステータスコード・フィールド名・レスポンス構造を観察します。すべてのアサーションは、観測された実際の動作に基づいています。
複数ステップのバックエンドフローでは、実際のレスポンスから得られる動的変数(作成されたリソースのID、返却されたセッショントークンなど)が後続ステップへ自動的に引き渡されます。シーケンス全体がエンドツーエンドで実行されるため、特定の順序で2つのエンドポイントを呼び出したときにのみ現れるバックエンドの不具合も、曖昧なアサーションエラーではなく具体的な問題として検出されます。
自然言語の指示が認証済みAPIコールに依存するフローをカバーする場合、Auto-Authが認証レイヤーを処理します。パスワードエンドポイント、OAuthリフレッシュトークン、AWS Cognitoのフローはテスト実行のたびに実行されます。エージェントは実際のログインフローを通じて認証済み状態に到達します。これは実際のユーザーと同じプロセスです。
コーディングエージェントが活用できる結果
自然言語テストセッションのアウトプットは、読むためのテストレポートではありません。コーディングエージェントが即座に活用できる構造化された情報です。
テストが成功した場合、開発者はエージェントが探索したフローが実行中のプロダクトで正しく動作していることを確認できます。テストが失敗した場合、失敗の詳細がIDEのチャットにコーディングエージェント向けの形式で届きます。内容は、実行されたユーザー操作・期待される結果・プロダクトが実際に返した結果です。コーディングエージェントはこの情報をもとに、同じセッション内で問題を特定し修正案を提示します。
これが、プロダクトレイヤーでの自然言語テストをコードレイヤーでの自然言語テストと区別する、クローズドループの本質です。コードレイヤーの失敗では、開発者がテストレポートをコード変更に翻訳する必要があります。プロダクトレイヤーの失敗では、コーディングエージェントが直接対処できるだけの十分なコンテキストが提供されます。
Auto-Heal Rerunは、UI変更によって動作上の問題ではなく構造上の理由でテストが失敗するケースに対処します。コンポーネントの名前変更、要素の移動、レイアウトのリファクタリングなどが発生しても、テストは誤検知で失敗するのではなく適応します。開発者はフィルタリングなしに信頼できる結果を受け取れます。
継続的インテグレーションにおいては、GitHub Actionsインテグレーションによって同じパイプラインをすべてのプルリクエストに組み込めます。コードがマージされる前に、プロダクトレイヤーの自動カバレッジが実行され、結果はPRコメントとして投稿されます。
まとめ
AIエージェントを使って自然言語でプロジェクトをテストすることは今日すでに可能であり、その体験はこれまでのテストアプローチとは大きく異なります。IDE内の一つの指示がテストセッションを起動し、プロダクト全体の表面をカバーし、実際のアプリケーションに対してリアルなユーザーフローを実行し、コーディングエージェントが直接活用できる形で結果を返します。
単に便利なだけでなく本当に役立つものにする鍵は、エージェントがその指示をどう処理するかにあります。TestSpriteは実際のユーザーのように実行中のプロダクトをナビゲートします。指示をコードアサーションに変換するのではなく、フローを実行し、結果を観察し、プロダクトレベルの言葉で発見内容を報告します。
AIコーディングツールがコードを生成するのと同じ速さで検証を行いたい開発者にとって、AIエージェントによる自然言語テストが本来提供すべきものは、まさにこれです。
今すぐAI IDEの中の一つの指示でTestSpriteを使ってプロジェクトをテストしてください。