AIコーディングエージェントが障害を起こし続ける理由(そしてその解決策)
 Zeshi Du
チェックアウトフローの追加をエージェントに依頼しました。エージェントは実行しました。そして次の作業へ移りました。2時間後、ログインページが動作しなくなっていることに気づきましたが、エージェントはまったく把握していませんでした。
これはモデルの問題ではありません。検証の問題です。そして、AIエージェントを大規模に活用するすべてのチームで発生しています。
見覚えのあるパターン
典型的な流れはこうです。エージェントが何かを構築し、テストがパスします(またはテストが存在しない)。エージェントは機能完了を報告します。あなたは次のタスクへ進みます。コンテキストウィンドウが圧縮された状態で動作するエージェントは、1時間前に自分が構築したものの全体像をもはや把握していません。
そして、関連する何かを変更します。ロジックが変化します。インポートが壊れます。フォームが送信できなくなります。エージェントは一度も監視していなかったため、気づきません。
あなたが問題に気づくころには、リグレッションは3セッション分の深さに達しており、追跡が困難になっています。
これはエージェントのバグではありません。大規模言語モデルの動作原理に組み込まれた構造的な制限です。
AIエージェントがリグレッションを起こす構造的な理由
あらゆるAIコーディングエージェント — Claude Code、Cursor、Cline、Codex — はコンテキストウィンドウ内で動作します。そのウィンドウには厳密なサイズ制限があります。セッションが長くなるにつれ、モデルは新しい指示のためのスペースを確保するため、古い情報を圧縮します。
2時間前に指示した要件は?ウィンドウ内にまだ残っているかもしれません。残っていないかもしれません。エージェントはどちらか教えることができません。
これにより、AIエージェントを活用してリリースするすべてのチームで繰り返し発生する、3つの障害モードが生まれます:
要件のドリフト。エージェントはセッション序盤に指定した制約を忘れ、微妙に誤ったものを構築します。コードは正しく見えます。機能は単体では動作します。しかし、エージェントがもはや記憶していないルールに違反しています。
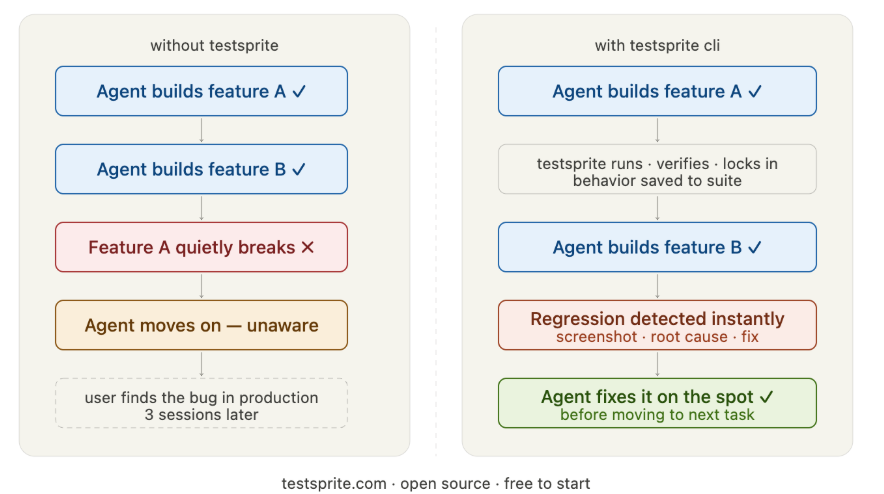
サイレントリグレッション。エージェントは機能Bを構築し、密かに機能Aを壊します。機能Aを監視するテストがなければ、ユーザーが発見するまで、あなたもエージェントも気づきません。
完了の幻覚。エージェントはタスクを完了として報告します。コードを書き、コードはコンパイルされ、関数は存在します。しかし実際のユーザーがそのページに遷移すると、何も動作しません。エージェントは実際にアプリを実行していなかったのです。
これら3つの障害モードは複合します。エージェントセッションが長くなるほど、いずれかが発生する可能性が高まり、回復はより困難になります。
従来のテストツールではこの問題を解決できない理由
自然な対応としてテストを追加することが考えられます。Playwrightをセットアップし、Cypressのスペックを書き、CIで実行する。
開発者がテストを書く場合、これはうまく機能します。しかし、セッション途中に自律エージェントとのリアルタイムなフィードバックループを確立しようとする場合は、うまく機能しません。
問題点:
- 誰かがテストを書く必要があります。エージェントもテストコードを書いている場合、エージェントは2つのものを同期して維持する必要があります:機能と、その機能のテストです。コンテキストが圧縮されると、どちらかがずれます。
- CIは事後に実行されます。パイプラインがリグレッションを検知するころには、エージェントはすでに次のタスクへ移っています。3タスク分の進捗を巻き戻すのは大変な作業です。
- モックは嘘をつきます。多くのテストセットアップはデータベース、API、ブラウザをモックしています。モックはパスします。実際のアプリは失敗します。そのギャップは本番環境でのみ明らかになります。
本当に必要なのは、エージェントがビルドの途中で自律的に呼び出し、実際のアプリを実行して即座に結果を報告するツールです。
正しいメンタルモデル:フィードバックループとしての検証
こう考えてみてください。人間の開発者はコードを書き、ブラウザで実行し、動作するかどうかを確認します。その緊密なループ — 書く、実行する、観察する、修正する — が品質を高い水準に保つものです。
AIエージェントにはそのループが欠けています。コードを書き、そして仮定します。ブラウザを実行しません。出力を観察しません。コードの形状から完成を推測するのであって、実行中のアプリの動作からではありません。
TestSprite CLIはそのループを閉じます。ビルドの途中でエージェント自身が呼び出せるツールを提供し、ライブブラウザで実際のエンドツーエンドのフローを実行して、エージェントがすぐに読んで対応できる構造化されたレポートを返します。
ループに人間は介在しません。CIを待つ必要もありません。エージェントはコードを書き、TestSpriteを呼び出し、結果を読み、問題を修正し、同じセッション内でそのまま作業を続けます。
TestSpriteの実際の動作
ショッピングサイトを例に挙げましょう。エージェントにチェックアウトフローを構築するよう依頼します。タスク完了を報告する前に、エージェントはTestSpriteを呼び出します。以下がその流れです。
- TestSpriteはクラウド上で実際のブラウザを起動します
- テストアカウントでアプリにログインします
- 商品を検索し、カートに追加し、チェックアウトに進み、支払い情報を入力して注文を送信します
- 正しい注文番号とともに注文確認ページが実際に表示されたことを確認します
いずれかのステップが失敗した場合 — カートボタンが反応しない、支払いフォームにエラーが返る、確認ページが空白になる — TestSpriteは正確な失敗箇所を記録します:スクリーンショット、DOMの状態、根本原因の仮説、そして推奨される修正方法です。
それらすべてがエージェントに返され、エージェントはレポートを読んでその場で問題を修正します。
フロー全体は実際のインフラ上で動作します。モックでも、シミュレーションでもありません。実際のユーザーが辿るのと同じ経路です。
複利的な優位性:永続的なメモリとしてのテスト
長時間にわたるエージェントセッションで最も重要な点がここにあります。
TestSpriteが正常に検証したすべての動作は、蓄積し続けるテストスイートに記録されます。エージェントが初めてログインの動作を確認したとき、そのテストは保存されます。チェックアウトがエンドツーエンドで初めて確認されたとき、そのテストも保存されます。
こうして検証済みの動作はコンテキストウィンドウの外に保存されます。エージェントのメモリは縮小・圧縮されるかもしれませんが、テストスイートは変わりません。プロジェクトが本来すべき動作の完全な履歴 — 数百の要件 — を保持しており、それはどんなコンテキストウィンドウにも収まりきらない量です。
その後のすべての変更は、スイート全体に対して検証されます。セッション1で正しいと証明されたものがセッション4で壊れた場合、TestSpriteは即座にそれを検出します。エージェントは次に進む前に修正します。
進捗が漏れ続けることはなくなります。要件がずれ続けることもなくなります。エージェントは単に忙しくなるのではなく、より優秀になっていきます。
1分以内にはじめる
セットアップは3つのコマンドで完了します。
npm install -g @testsprite/testsprite-cli
testsprite config set-key YOUR_API_KEY
testsprite agent install
最後のコマンドはTestSpriteをエージェントのツールリストに登録します。その後はエージェントが自律的に呼び出します。追加のコマンドは不要です。セッションの進行中はポータルを確認するだけです — 生成されたすべてのテスト、録画、根本原因がすべてログに記録され、ブラウザで確認できます。
無料ティアは月150クレジットで利用可能です。実際のプロジェクトにTestSpriteを組み込み、検証レイヤーを導入したエージェントのパフォーマンスを確認するには十分な量です。
まとめ
AIコーディングエージェントがコードを壊すのは、コーディングが苦手だからではありません。自分が構築したものが実際に動作しているかを確認する手段がなく、すでに正しいと証明したことを記憶しておく方法もないからです。
TestSprite CLIはその両方を提供します。失敗が発生した瞬間に検出するリアルタイムのフィードバックループと、どんなコンテキストウィンドウよりも長く保持される検証済み動作の永続的な記録です。
AIエージェントで高速に開発することの代償がリグレッションである必要はありません。適切な検証レイヤーがあれば、リグレッションは例外的な出来事となり — あなたのもとに届く前に検出・修正されます。
はじめる: github.com/TestSprite/testsprite-cli