KaneAI vs TestSprite:AIで生成されたコードのテストに優れたAI QAエージェントはどちら?
 Zeshi Du
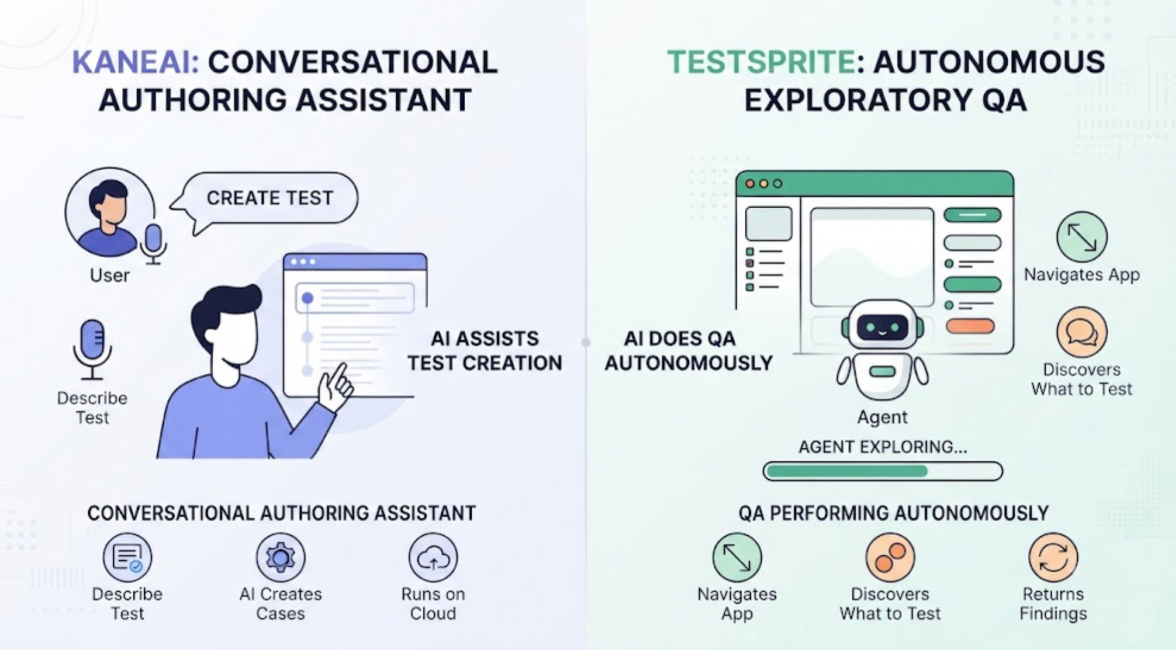
KaneAIとTestSpriteはいずれもQAにAIエージェントを活用しています。違いは、それらのエージェントが何をしているか、そしてどこで行っているかです。
LambdaTestのAI QAエージェントであるKaneAIは、会話型のテスト作成を中心に構築されています。AIエージェントと対話して希望するテストを説明すると、エージェントがその説明を実行可能なテストケースに変換し、LambdaTestのクラウドインフラ上でブラウザやデバイスをまたいで実行します。GenAIはオーサリングインターフェースに組み込まれており、手動で記述するよりも効率的にテストを作成できます。
TestSpriteのAIエージェントは異なる動作をします。テストの作成を支援するのではありません。実行中のアプリケーションを自律的にナビゲートし、プロダクトを使用することでテスト対象を発見し、シナリオを事前に記述することなく結果を返します。GenAIはあなたをサポートするのではなく、QA作業そのものを実行します。
AIで生成されたコードのテストに特化すると、この違いが最も重要な障害を検出するツールを決定します。
AIで生成されたコードが異なるテスト要件を持つ理由
Cursor、Claude Code、GitHub CopilotなどのAIコーディングエージェントが生成するコードには、テスト方法に影響を与える特有の特性があります。
変化が速い。1回のAIコーディングセッションで数十のファイルに触れ、複数のAPIを変更し、複数のフロントエンドコンポーネントを同時に更新することがあります。これにより生じる統合障害は、変更された個々のファイルには現れないことが多く、それぞれが独立して正しく動作するコンポーネント間の接合部に現れます。
AIのIDE内で生成される。Claude Codeはターミナルで動作します。CursorはIDEのチャットインターフェースで動作します。テストシナリオの作成、実行のトリガー、別のダッシュボードでの結果確認のためにその環境を離れる必要があるテストツールは、反復するたびに摩擦が増大します。
最も重要なバグはプロダクトレイヤーの障害です。内部的に一貫したコードでも、レイヤーが正しく連携しないとユーザーに誤った結果をもたらすことがあります。それらの障害を検出するには、ソースファイルを分析するのではなく、実際のプロダクトを実行して何が起こるかを観察する必要があります。
KaneAIのモデルとAIコーディングチームへの適合性
KaneAIの会話型テスト作成モデルは、効率的にテストカバレッジを作成したいQAチームに適しています。AIエージェントは「このフローをテストしたい」から「LambdaTestのクラウドで実行しているテストケースがある」までのプロセスを加速します。
構造化されたQAプロセスを持つ組織の専任QAエンジニアにとって、KaneAIはテストライブラリの構築に必要な時間と専門知識を削減します。LambdaTest上のクロスブラウザ・クロスデバイスインフラは、多くの環境でカバレッジが必要なチームにとって本物の機能です。
AIコーディングチームにとっての制限はオーサリングステップです。KaneAIはオーサリングを高速化しますが、どのシナリオをオーサリングするかを決定するのは依然として開発者やQAエンジニアです。Claude Codeが12個のファイルを変更したチームにとって、「KaneAIにどのシナリオを記述すべきか」という問い自体が大きな認知的負荷です。そして、AIコーディングセッションが最も頻繁に引き起こす統合障害は、思い浮かぶシナリオの外に潜んでいます。
AIで生成されたコードに対するTestSpriteのモデル
TestSpriteは、AIコーディングチームがどのシナリオをテストするかを決定する時間がないという前提のもとに構築されています。エージェントがプロダクトを探索することで判断します。
TestSprite MCPサーバーを通じて、Claude Code、Cursor、Windsurf、またはVS Code内からの1つの指示が完全な自律パイプラインをトリガーします:
「TestSpriteでこのプロジェクトをテストしてください。」
他の検証ツールはコードを読んで推測します。TestSpriteはあなたのアプリを開いて実際に使います。
並列探索エージェントのフリートが実行中のアプリケーションにアクセスし、実際のユーザーと同じようにナビゲートします。AIコーディングセッションで変更されたファイルは読みません。ライブプロダクトにアクセスし、フローを発見して実行します。カバレッジには誰も指定しようと思わなかったフローも含まれており、そこにこそAIコーディングセッションによる統合障害が最も多く潜んでいます。
テストが失敗すると、構造化された障害の説明がIDEに返されます。コードを記述したコーディングエージェントが障害を受け取り、同じセッション内で修正を提案できます。ツールを切り替えることなくループが完結します。
AIで生成されたコードが引き起こす特有の障害モード
AIコーディングエージェントは、特定のスコープ内で指定された動作を実装することに長けています。しかし、複数のファイルにわたって変更が発生する際に、プロダクトの異なる部分間のコントラクトを維持することはあまり得意ではありません。
プロジェクト管理API、それを使用するコンポーネント、共有状態管理レイヤーを更新するClaude Codeセッションは、個々のピースがそれぞれ正しく動作しているにもかかわらず、プロダクト全体が壊れる状況を生み出すことがあります。配送方法を選択した後にクーポンが適用されると失敗するチェックアウト。3つのコンポーネントが依存するキャッシュが無効化されなくなったためにステールデータを表示するダッシュボード。ユーザーを正しくログインさせるが、同じAIセッションで変更されたプロダクトのセクションにセッションを伝播させることに失敗する認証フロー。
これらの障害はテストライブラリに存在しないためKaneAIには現れません。TestSpriteではエージェントが変更後にプロダクトの全サーフェスをナビゲートし、ユーザーと同じ方法で探索するため検出されます。
バックエンドAPIコントラクト検証
バックエンドロジックが複雑なチームにとって、最も重要な機能のひとつが、AIコーディングセッション後のAPIコントラクト破損を検出することです。
KaneAIは、記述したシナリオからAPIテストを生成します。安定していてドキュメントが充実したAPIに対しては、これは効果的に機能します。
TestSpriteのBackend Testing 2.0は、アサーションを生成する前にAPIを実際に呼び出します。エージェントはリアルなレスポンスを観察します。実際のフィールド名、実際のステータスコード、実際のレスポンス形式です。アサーションは、APIが実際に返す内容に基づいて構築されます。
AIが生成したバックエンドコードにおいて、これが重要な理由があります。実際に動作しているAPIは、ソースコードが示す仕様と頻繁に異なるからです。シリアライゼーション層は、コード解析では考慮されない命名規則を適用します。リファクタリングにより、一部の箇所ではフィールド名が変更されても、すべての箇所では変更されないことがあります。観察ファーストのアプローチは、最初の実行時にこうした不一致を検出します。シナリオ記述によるアサーションでは、最初から誤ったフィールド名をエンコードしてしまう可能性があります。
Claude Codeのセッションがバックエンドを変更してフィールドがリネームされた場合、次回のTestSprite実行時に以前に観察されたコントラクトと比較し、その差異を具体的な検出結果として表示します。
シナリオ:ライブラリに存在しなかったテスト
5人のスタートアップがClaude Codeを主要な開発ツールとして活用しています。彼らはコアフローのテスト作成にGenAIアシスト型のテスト作成アプローチを採用しています。対象はユーザー登録、プロジェクト作成、および請求処理です。テストライブラリは、チームが記述する時間を確保できた内容をカバーしています。
彼らはTestSpriteをClaude Codeに接続し、セッション後の検証に活用しています。
複数のユーザーが同一プロジェクトで同時作業できるようにするプロジェクトコラボレーション機能を更新するClaude Codeセッションの後、彼らはTestSpriteを起動します。
探索エージェントはコラボレーション機能をナビゲートします。ユーザーAとしてプロジェクトを作成し、ユーザーBを招待し、ユーザーBとしてプロジェクトに移動して編集を行います。
次に、プロジェクトへの全変更履歴が表示されるプロジェクト履歴セクションに移動し、ユーザーBが編集を行ったことが表示されるはずのユーザーAの通知センターに移動します。
プロジェクト履歴にはユーザーBの編集が正しく表示されていることが確認されました。しかし、ユーザーAの通知センターには新しい通知が0件の状態です。コラボレーション機能は編集内容と履歴を正しく作成しています。リアルタイムコラボレーションイベントの通知ディスパッチは、Claude Codeセッションでは実装されておらず、データ永続化レイヤーのみが実装されていました。
テストライブラリはプロジェクト作成をカバーしていました。しかし、「コラボレーターを招待し、編集を行い、プロジェクトオーナーが通知を受信することを確認する」というシナリオは誰も記述していませんでした。チームのメンバーは、テスト作成をセットアップした際にそのステップシーケンスを記述することを思いつかなかったのです。
TestSpriteのエージェントは通知センターに移動しました。コラボレーターのアクティビティ通知を期待するプロジェクトオーナーは、そこを確認するはずだからです。
失敗の詳細がClaude Codeに返されます。コーディングエージェントは欠落している通知ディスパッチを特定し、修正を適用します。コラボレーション機能はセッションが終了する前に完成します。
まとめ
AIが生成したコードのテストにおいて、より優れたAI QAエージェントとは、人間が記述したシナリオを実行するのではなく、テストシナリオを自律的に発見できるエージェントです。
KaneAIはシナリオ作成をより迅速かつ効率的にします。構造化されたテストライブラリを構築するQAチームにとって、会話型の作成モデルとLambdaTestのクロスブラウザインフラは本物の強みです。
TestSpriteは、開発セッション内で検証を完結させる必要があるAIコーディングチームのために、作成ステップそのものを排除します。探索エージェントは実際のユーザーのように製品をナビゲートします。Backend Testing 2.0は観察したAPIの動作に基づいてアサーションを構築します。そして結果は、コーディングエージェントが直接アクションできる形式でIDEに返されます。
Claude CodeやCursorが開発環境であり、コンテキストの切り替えやテスト作成セッションなしに検証を行う必要があるチームにとって、TestSpriteは最適なモデルです。
TestSpriteをClaude CodeまたはCursorに接続し、今日まさにコードが書かれているセッション内でAI生成コードをテストしましょう。